 AI Briefing
omlx: M3 Ultra 기준 GLM-5.2 프리필 30배 가속
jundot/omlx
프로젝트 소개
로컬 LLM 서버는 편의성과 제어력 사이에서 타협해야 하는 경우가 많았다. oMLX는 macOS 메뉴바에서 모델 로딩, 컨텍스트 제한, 메모리 할당을 직접 조정할 수 있도록 설계됐다. 일상적으로 쓰는 모델은 메모리에 고정하고, 무거운 모델은 필요할 때 자동으로 교체한다.
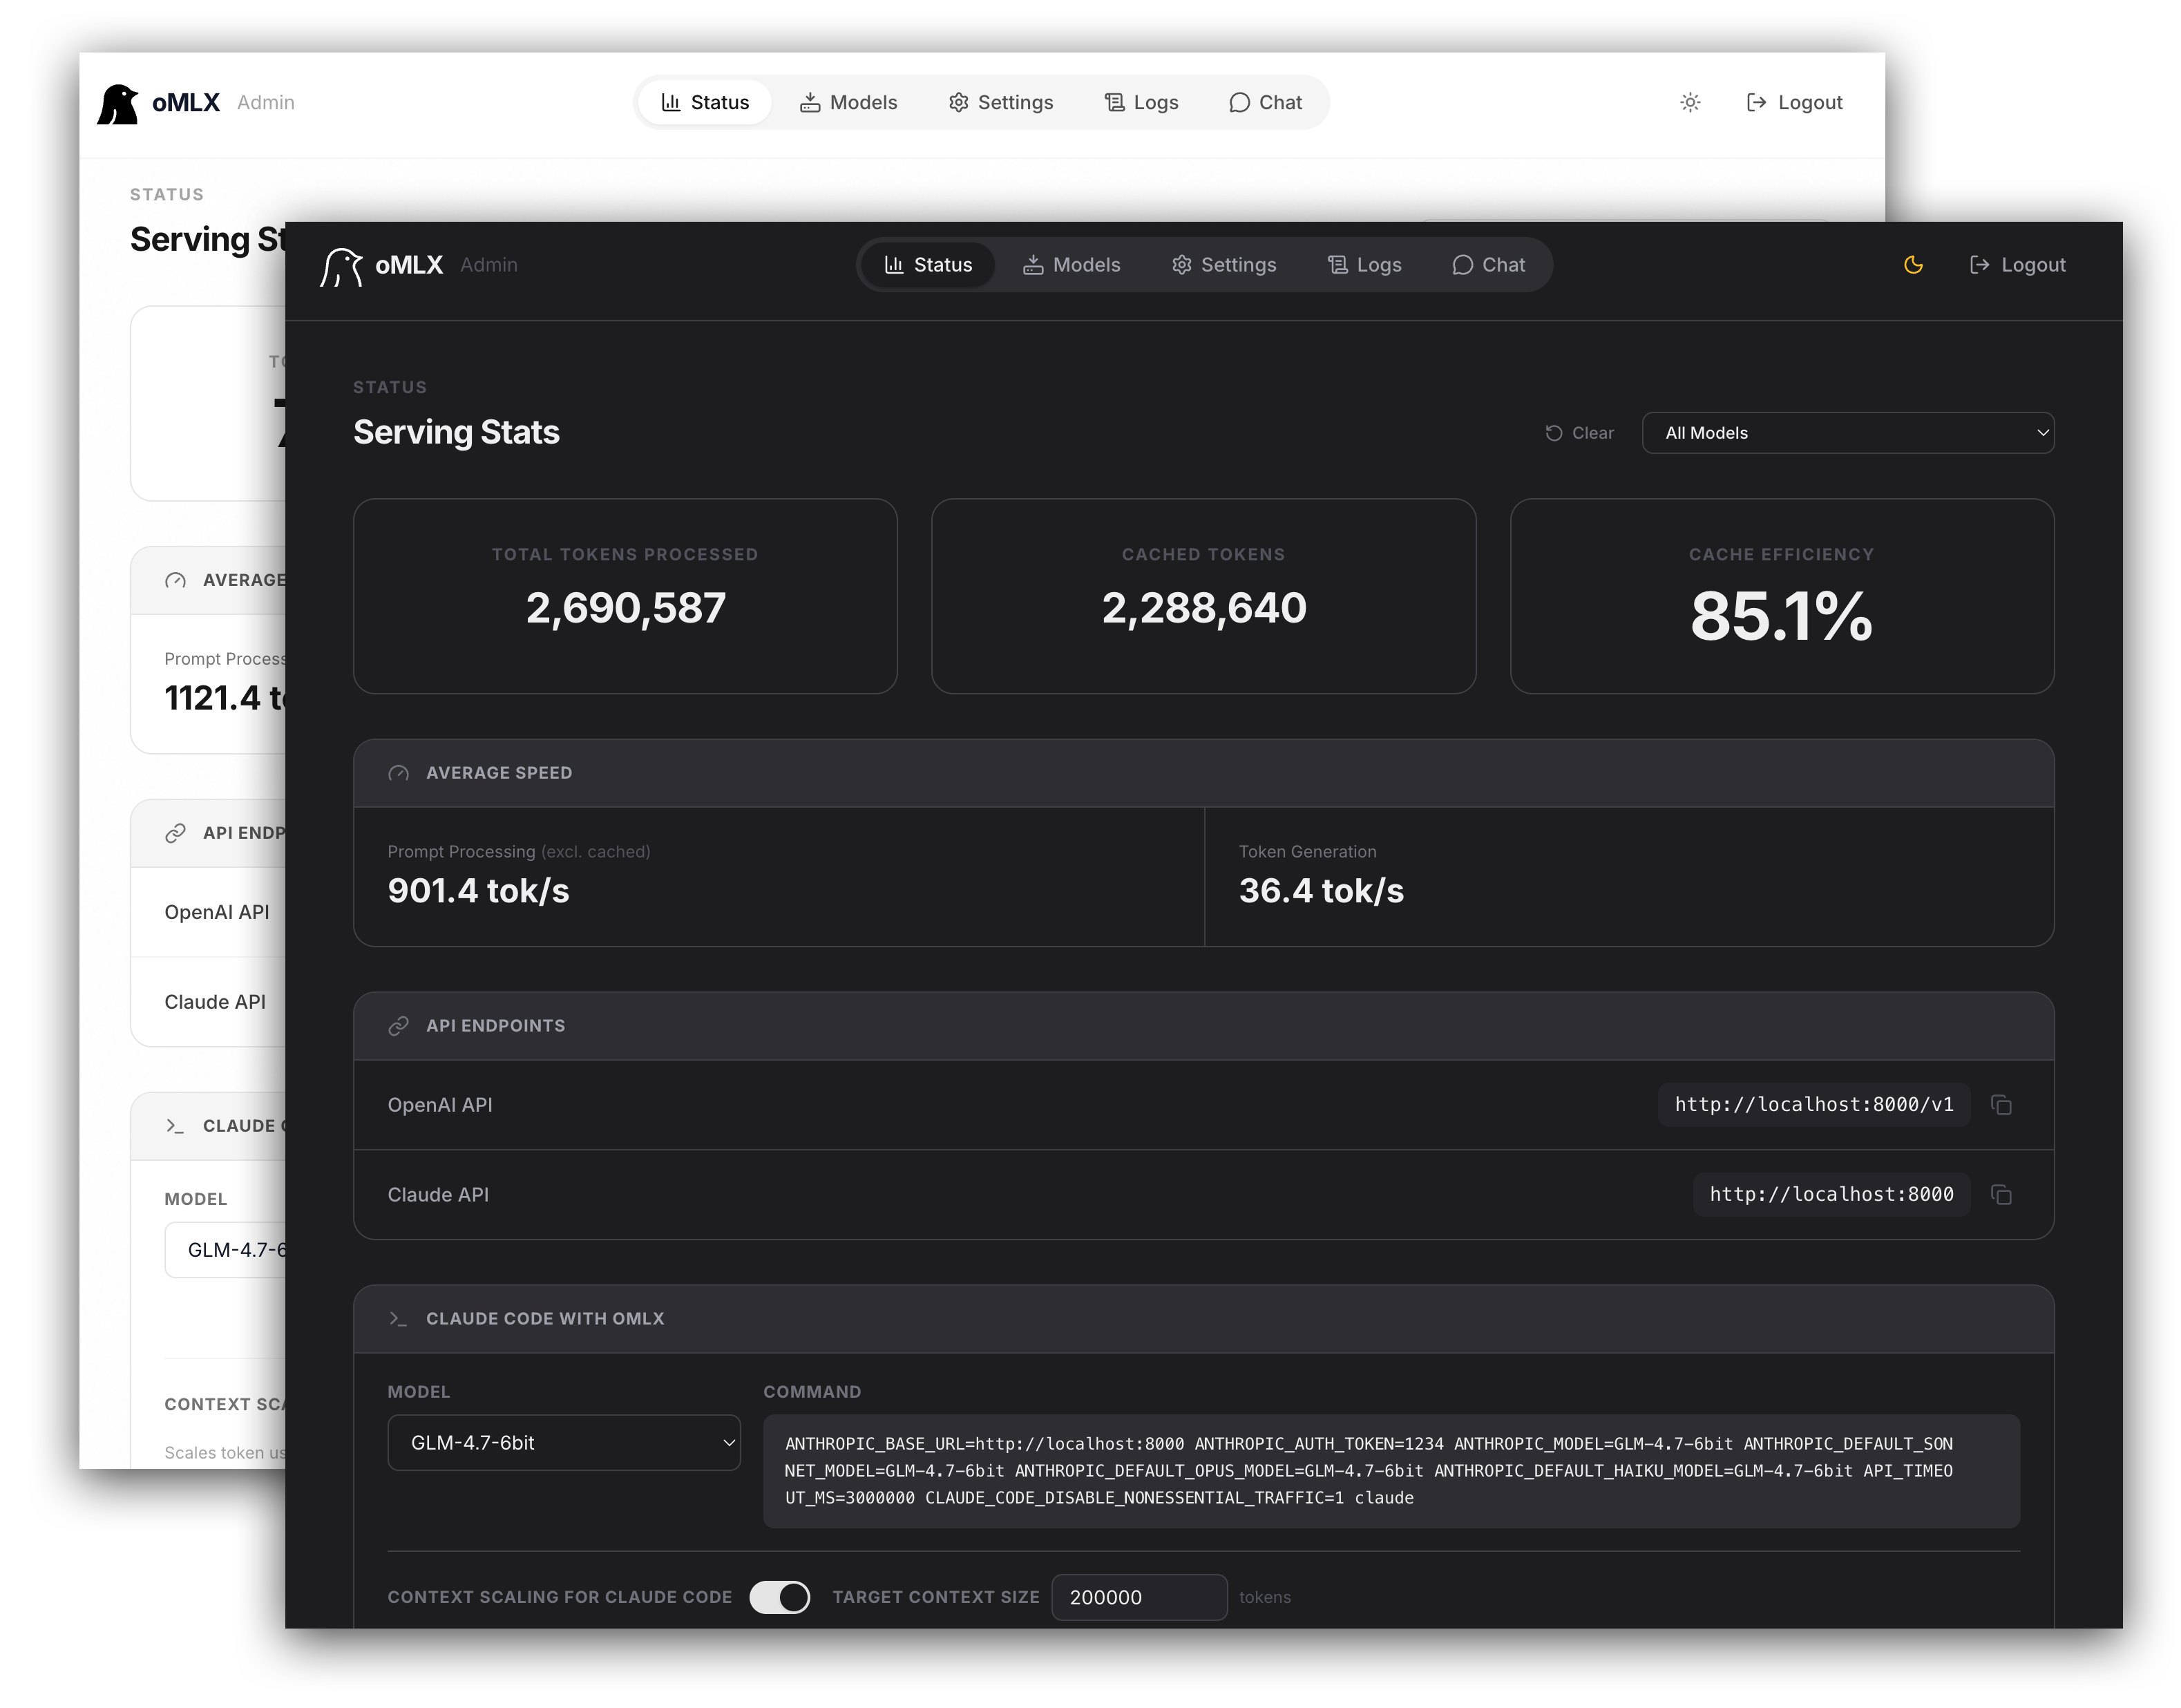
핵심은 RAM과 SSD를 아우르는 2단계 KV 캐시 구조다. 자주 쓰는 블록은 RAM에 두고, 용량이 차면 SSD로 오프로딩한다. 서버를 재시작해도 이전 컨텍스트가 캐시로 남아 있어 재계산 없이 요청을 처리할 수 있다. Claude Code 같은 도구와 함께 쓸 때 긴 대화 맥락을 유지하는 데 유리하다.
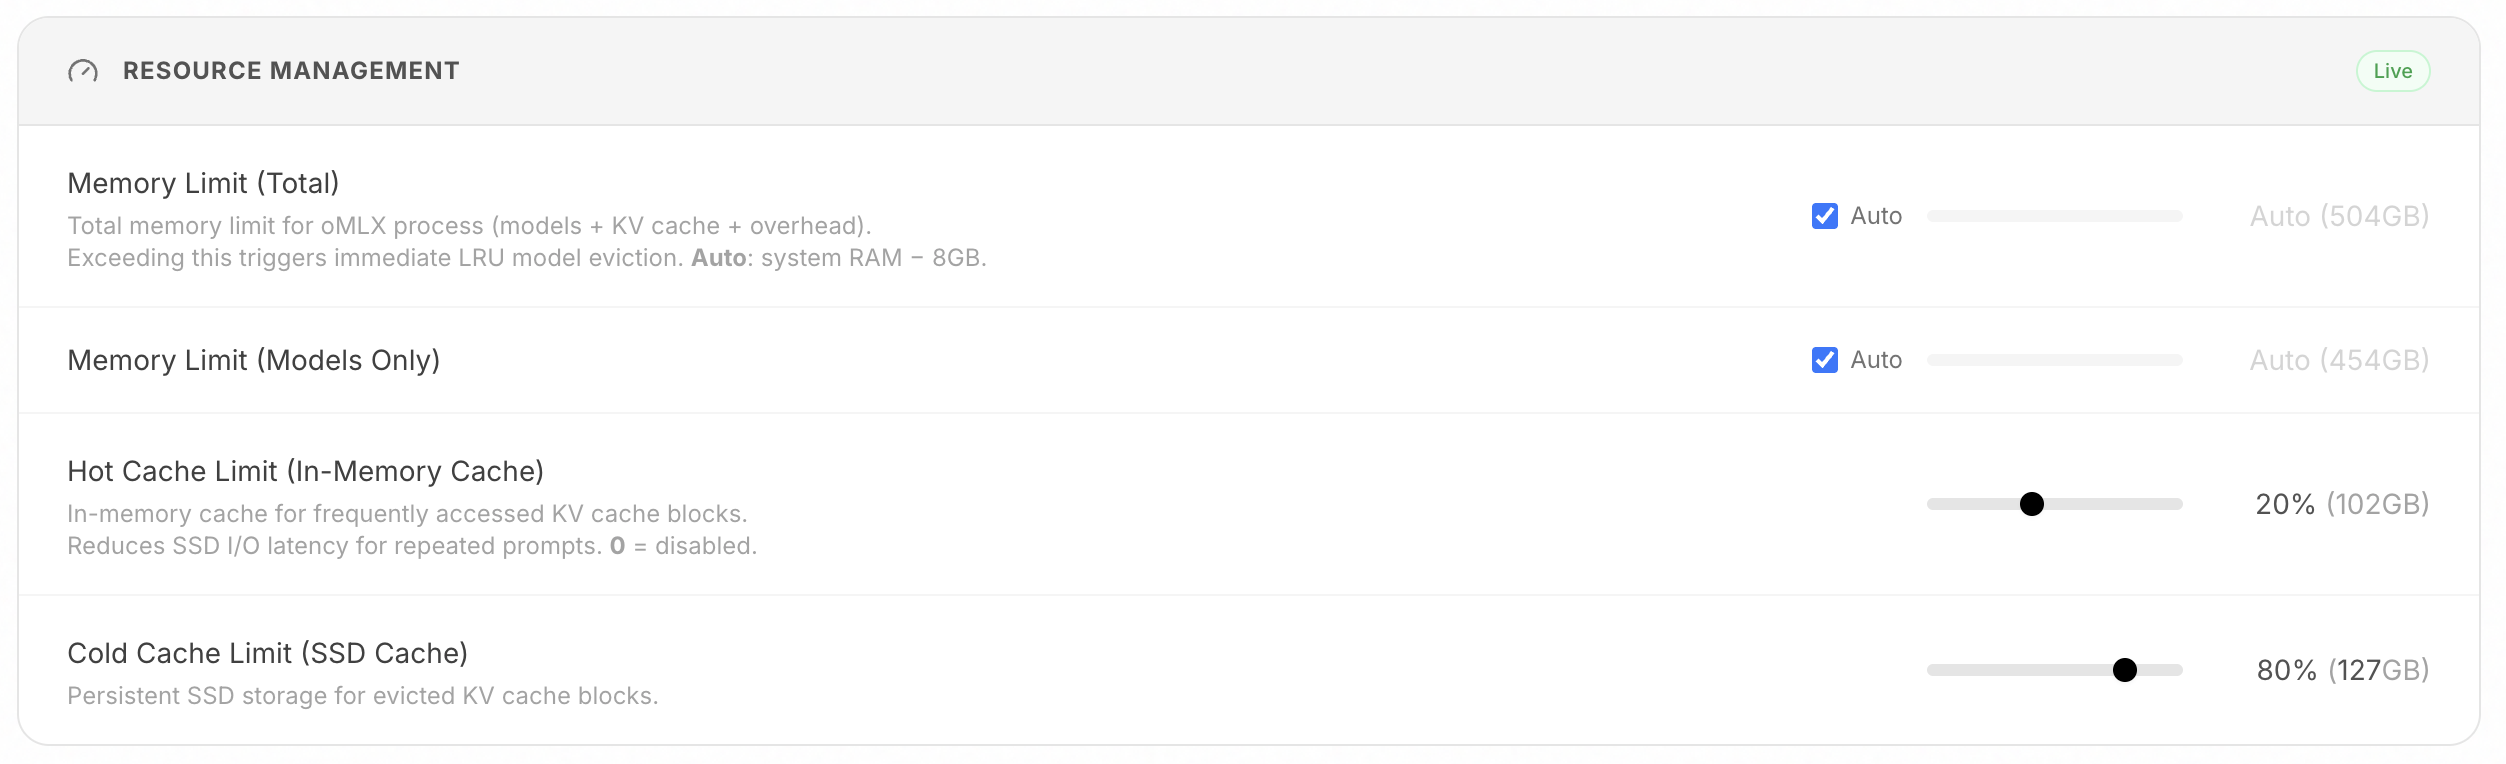
텍스트 LLM뿐 아니라 VLM, OCR, 임베딩, 리랭커까지 하나의 서버에서 동시에 돌린다. LRU 방식의 자동 교체와 수동 고정, 모델별 TTL 설정을 통해 메모리 사용량을 세밀하게 통제한다. OpenAI 호환 API를 제공하므로 기존 클라이언트 코드 수정 없이 연결할 수 있다.
Apple Silicon(M1~M4)과 macOS 15.0 이상 환경에서 동작한다. 특히 GLM-5.2나 MiniMax M3 같은 특정 모델 계열은 네이티브 커널 빌드 시 성능 차이가 크다. M3 Ultra 기준 GLM-5.2 프리필 속도가 일반 경로 대비 약 30배 빠르다. 로컬에서 코딩 에이전트를 돌리거나, 클라우드 의존도를 줄이고 싶은 개발자에게 적합하다.
jundot/omlx
LLM inference server with continuous batching & SSD caching for Apple Silicon — managed from the macOS menu bar
Python
이 한국어 소개글은 AI가 자동으로 만들었습니다. 원문의 주장과 맥락은 원문에서 확인해 주세요. 저작권은 원저작자에게 있습니다.