 AI Briefing
laya: 33ms 만에 100개 언어로 분류·판단 끝내는 비자기회귀 엔진
NandhaKishorM/laya
프로젝트 소개
텍스트 생성 없이 단일 forward pass로 분류와 판단을 끝내는 비자기회귀(non-autoregressive) 의사결정 엔진이다. 이메일, 티켓, JSON 등 다양한 입력 상태를 받아 선택(choice), 점수(score), 확률(noul) 형태의 구조화된 결과를 즉시 반환한다. 생성형 모델과 달리 파싱 오류나 환각(hallucination) 위험이 없어 신뢰성 높은 자동화가 가능하다.
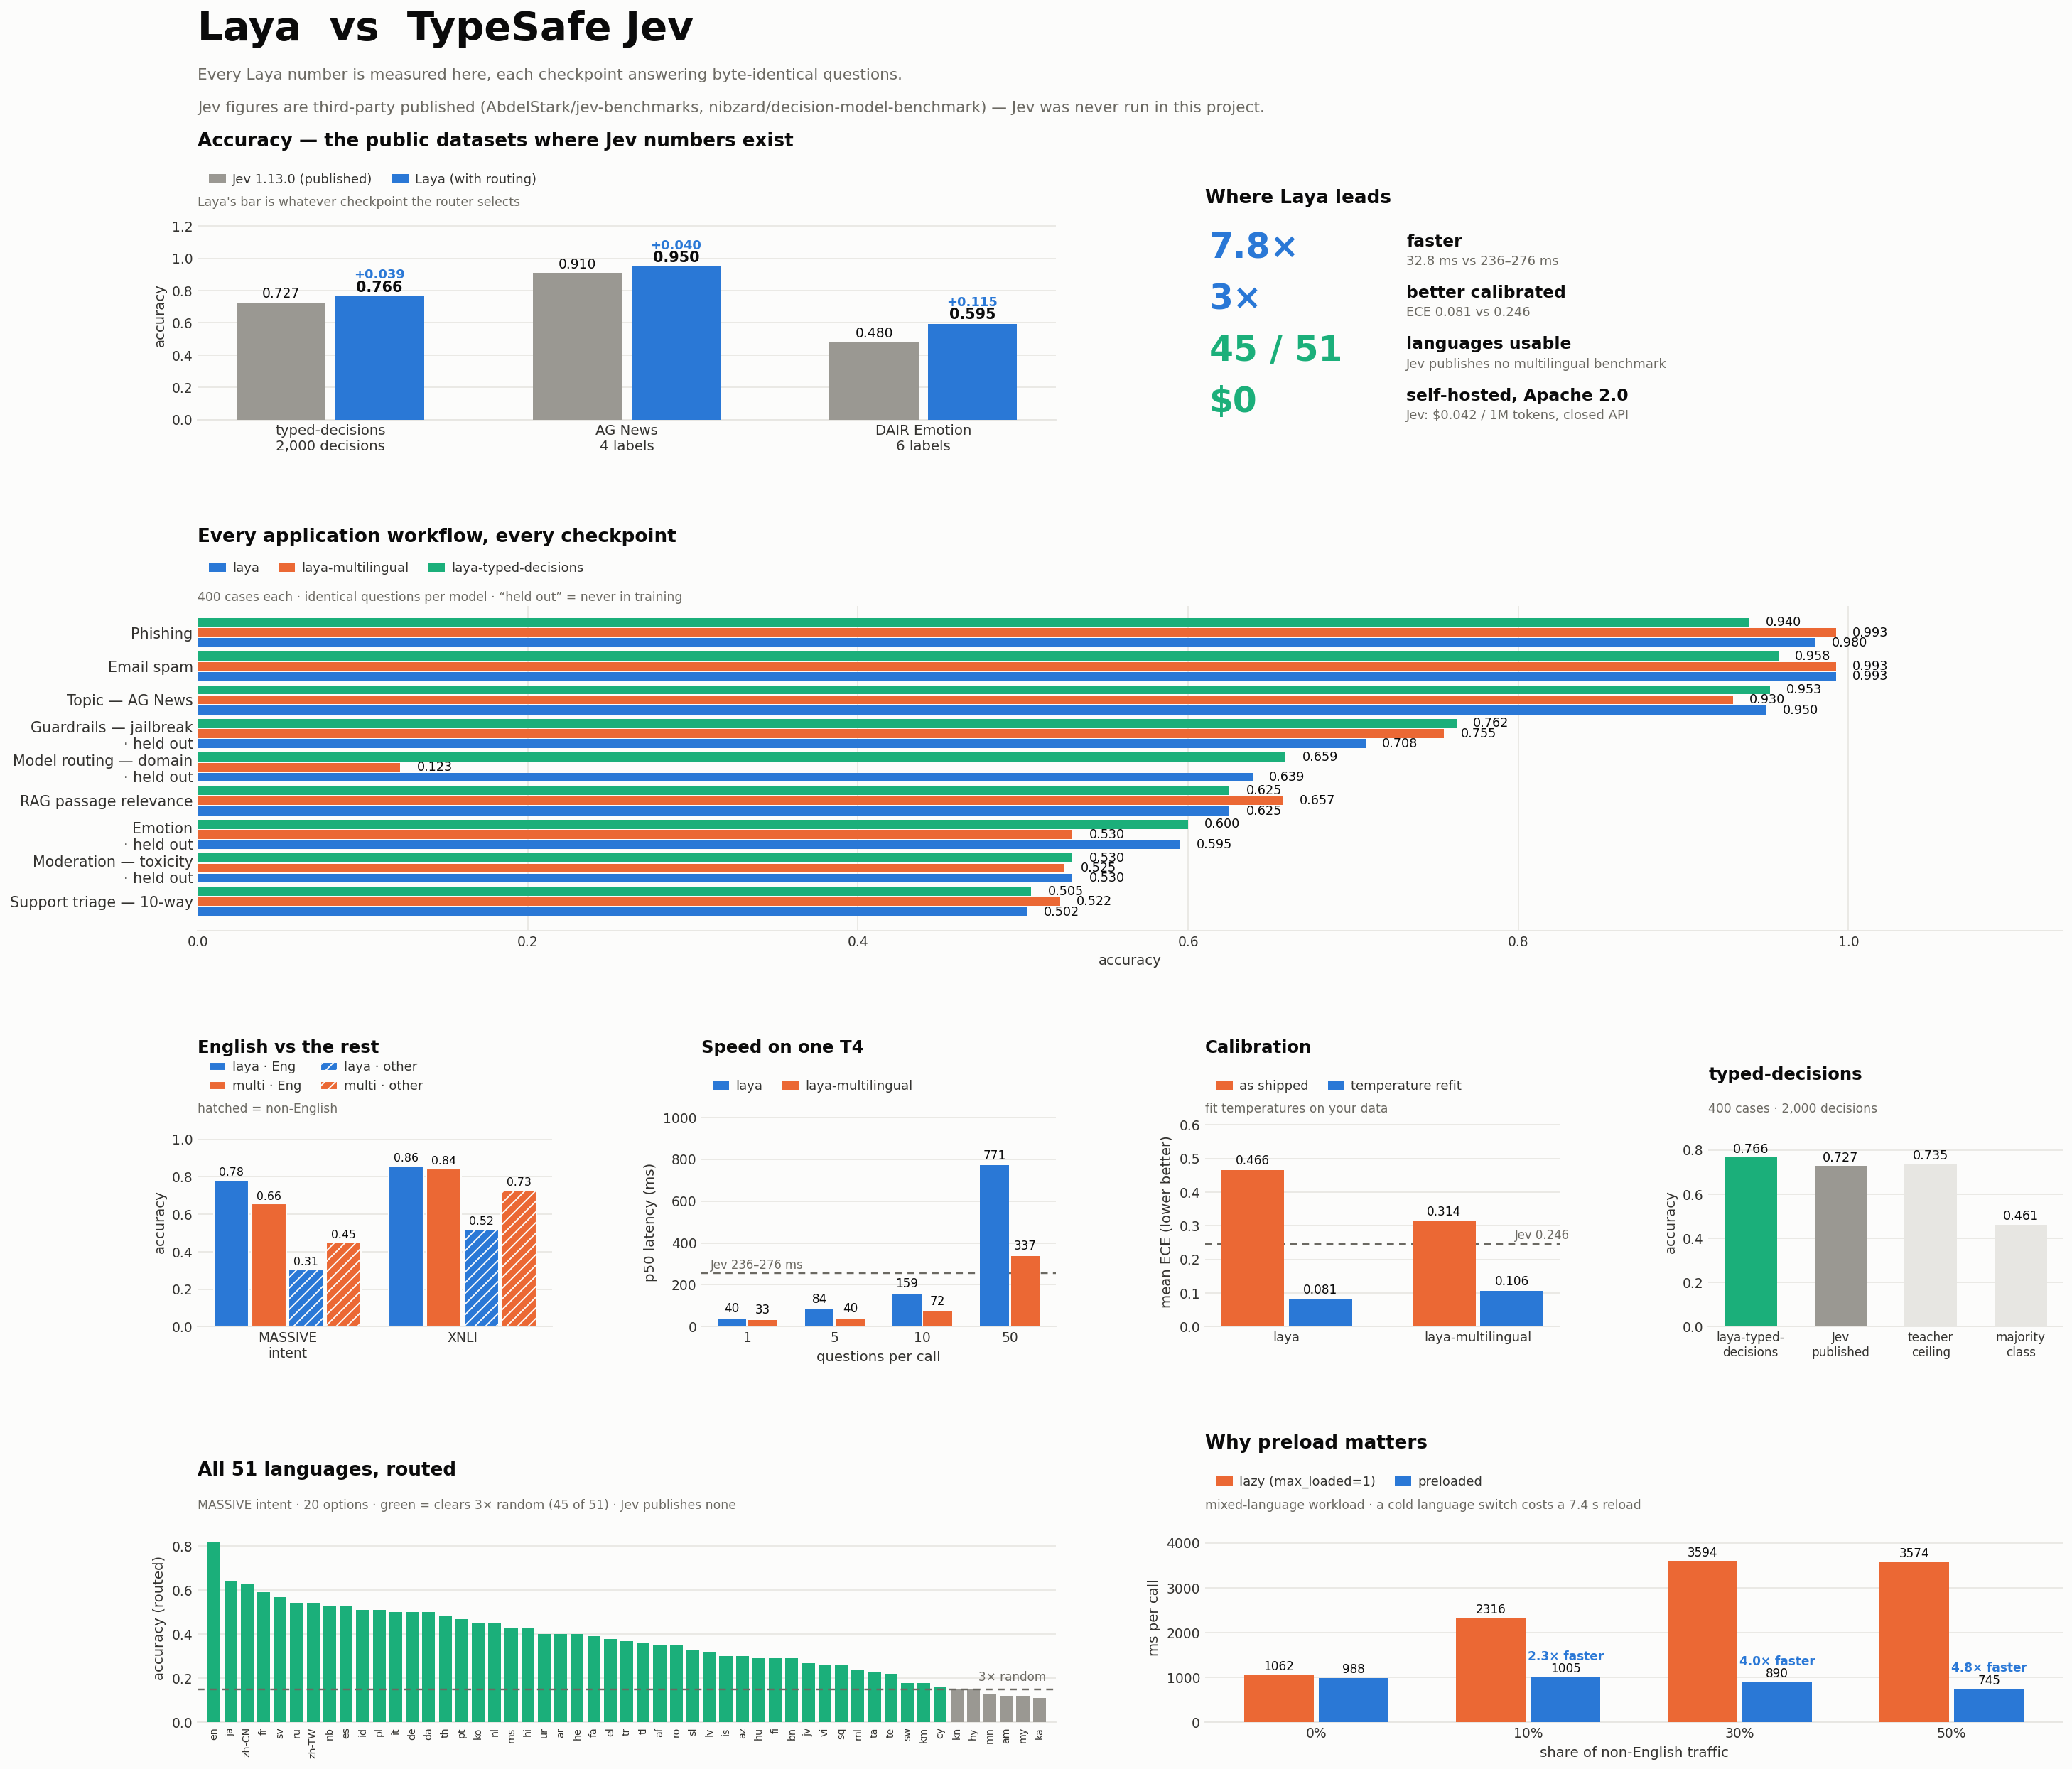
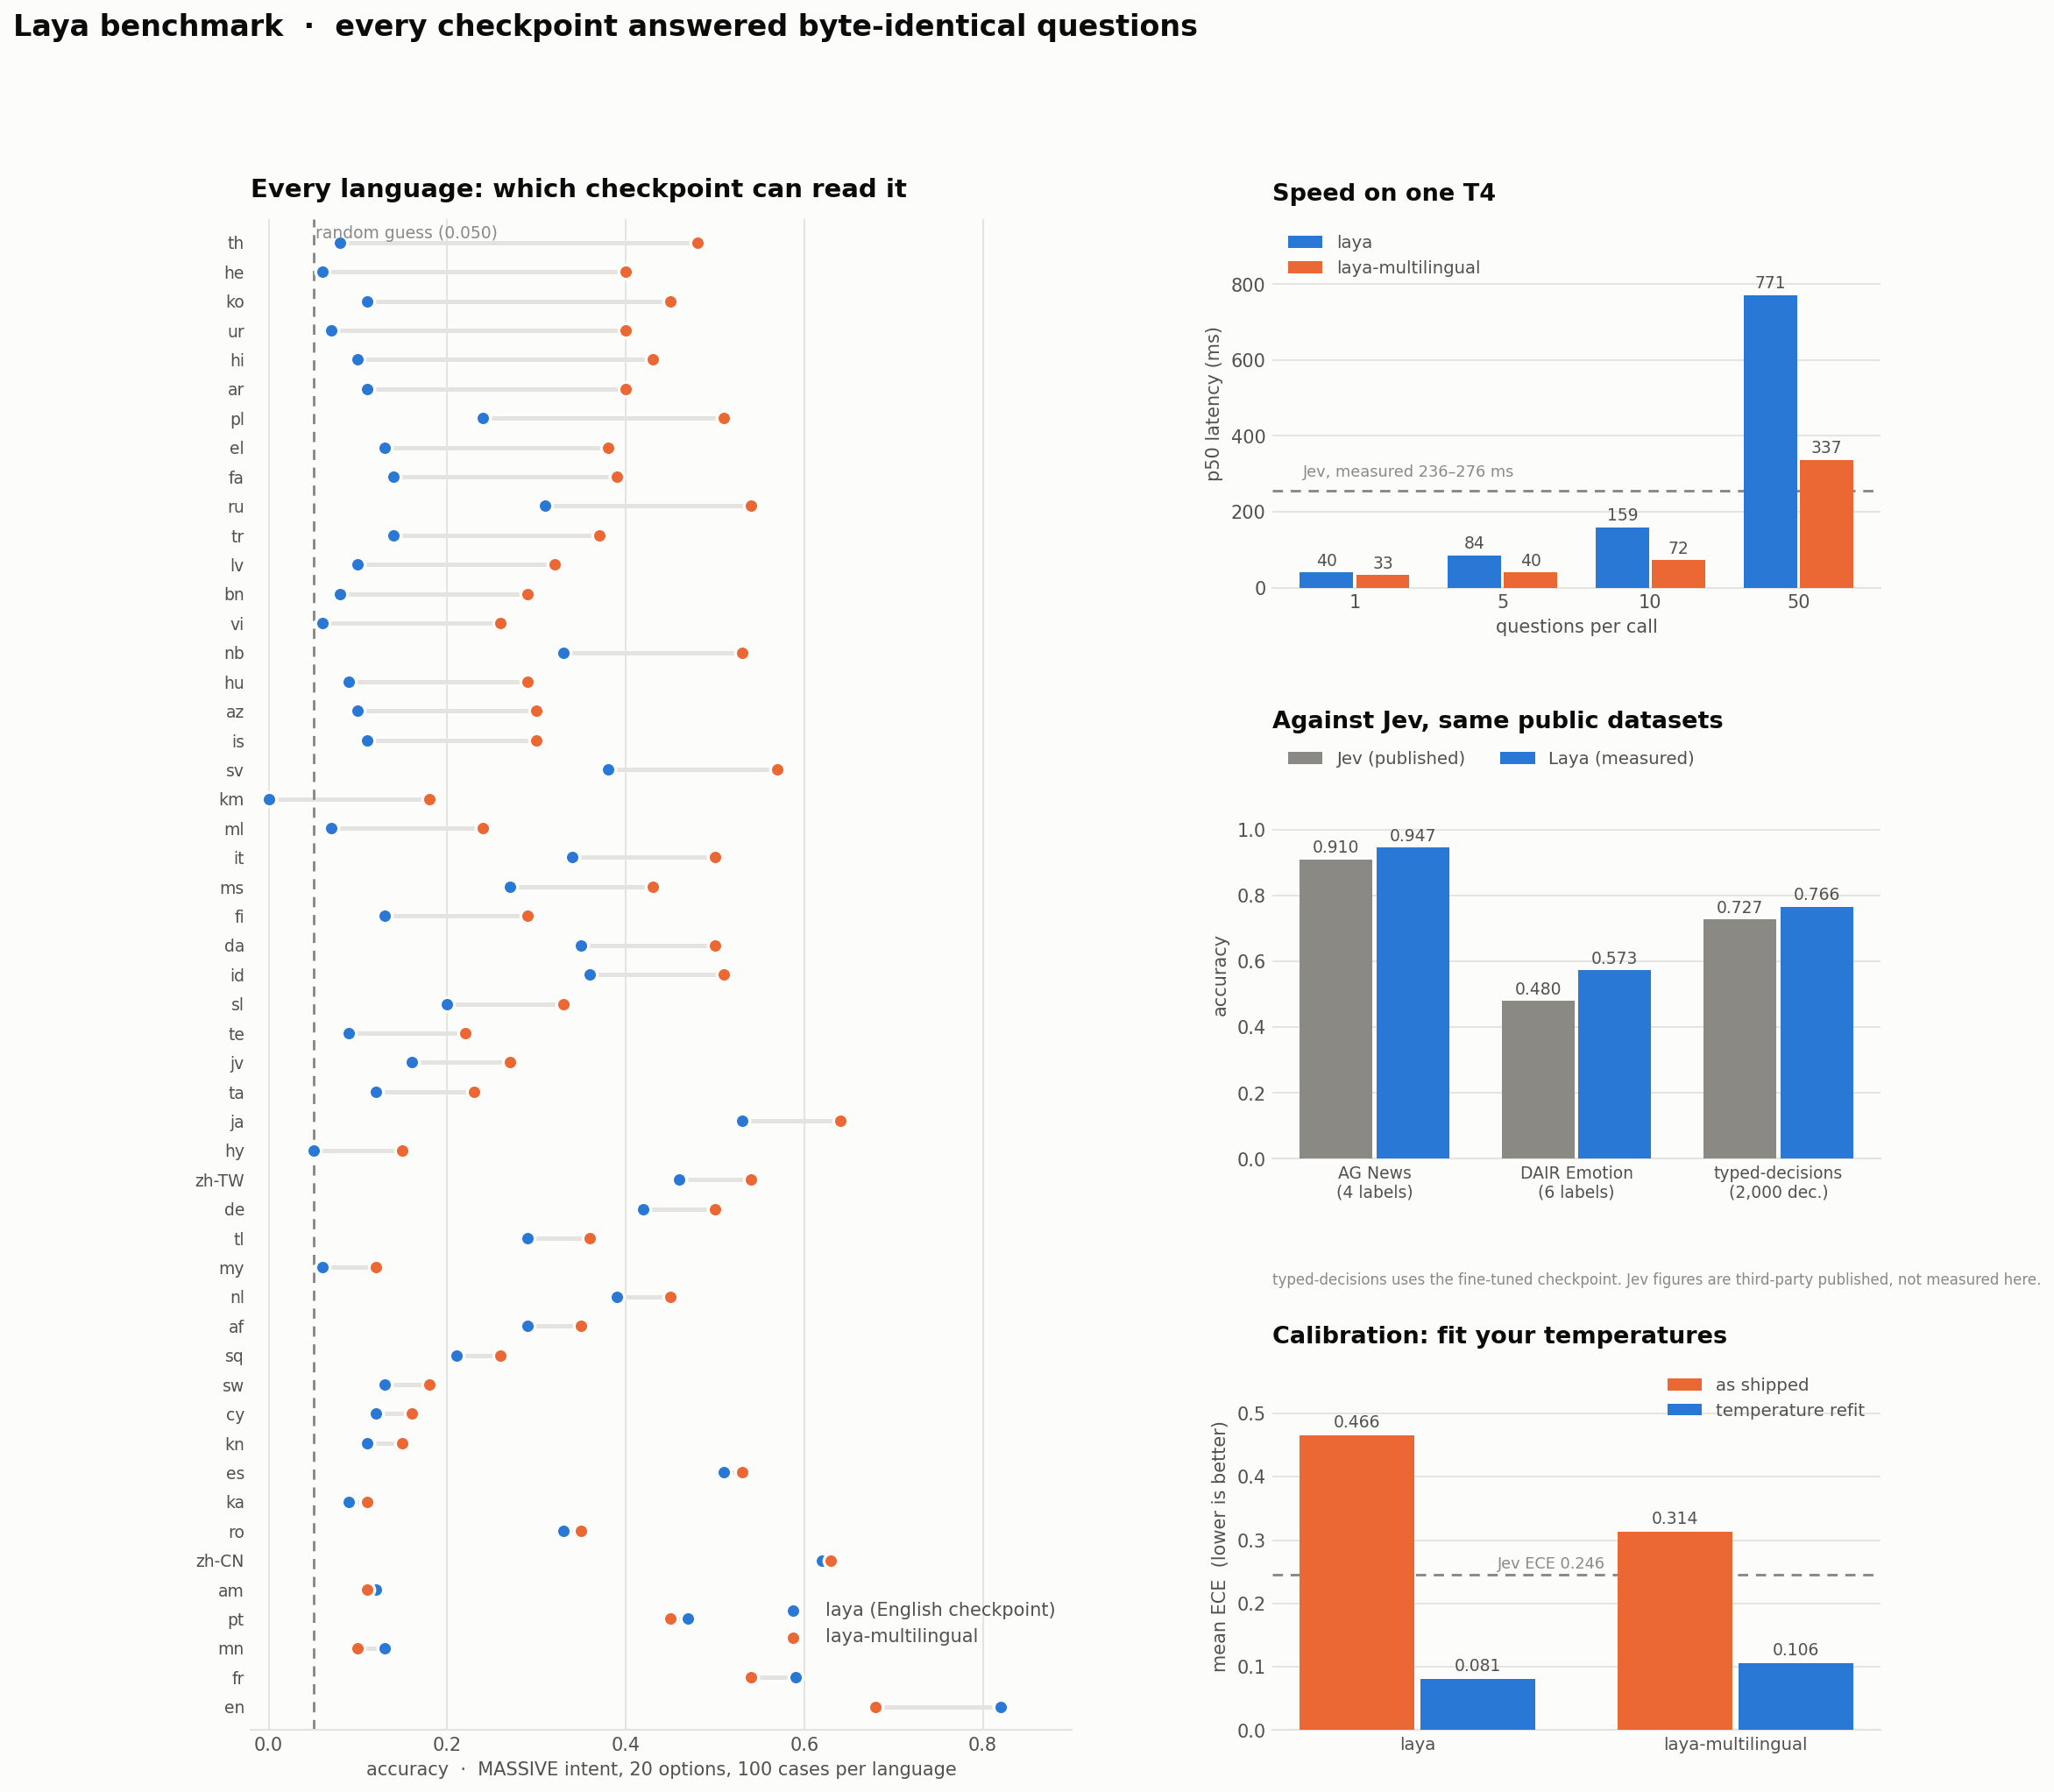
T4 GPU 기준 단일 질문 처리에 33ms, 배치 처리 시 질문당 7.2ms의 초저지연 성능을 제공한다. 영어 전용 모델과 100개 이상 언어를 지원하는 다국어 모델, 특정 워크플로우 최적화 모델 등 세 가지 체크포인트를 내장했다. 요청 언어와 작업 유형을 감지해 가장 적합한 모델을 자동으로 라우팅하며, 필요 시 수동으로 지정할 수도 있다.
엄격한 점수 규칙(Strictly Proper Scoring Rules) 기반 강화학습으로 학습되어 확률 값이 통계적으로 유의미하다. 높은 신뢰도 점수를 받으면 자동 처리하고, 낮으면 인간 상담원에게 에스컬레이션하는 Confidence Gating 로직을 쉽게 구현할 수 있다. 모델 라우팅, 프롬프트 가드레일, 콘텐츠 모더레이션, 티켓 분류 등 4가지 사전 설정된 워크플로우를 제공한다.
다국어 지원이 필요한 글로벌 서비스나 실시간 분류가 필수적인 CS 자동화, 보안 필터링 시스템에 적합하다. 영어 외 언어에서 성능이 급격히 떨어지는 기존 영어 중심 모델의 한계를 보완하며, 언어 감지를 기반으로 정확한 체크포인트를 선택해 정확도를 유지한다. Apache 2.0 라이선스로 상업적 활용이 자유롭다.
NandhaKishorM/laya
Non-autoregressive System 1 decision engine. Typed choice, score and yes/no decisions over any text in a single forward pass, in 100+ languages, with a router that picks the right checkpoint per request.
Python
이 한국어 소개글은 AI가 자동으로 만들었습니다. 원문의 주장과 맥락은 원문에서 확인해 주세요. 저작권은 원저작자에게 있습니다.