 AI Briefing
추천headroom: JSON 데이터 95% 압축, LLM 응답 속도 체감
headroomlabs-ai/headroom
프로젝트 소개
AI 에이전트가 LLM에 보내는 토큰 양을 줄여주는 컨텍스트 압축 레이어다. 도구 출력, 로그, RAG 청크, 파일, 대화 이력 등 에이전트가 읽는 모든 데이터를 LLM에 도달하기 전에 압축한다. 동일한 답변을 유지하면서 입력 토큰을 대폭 절감하는 것이 핵심 목표다.
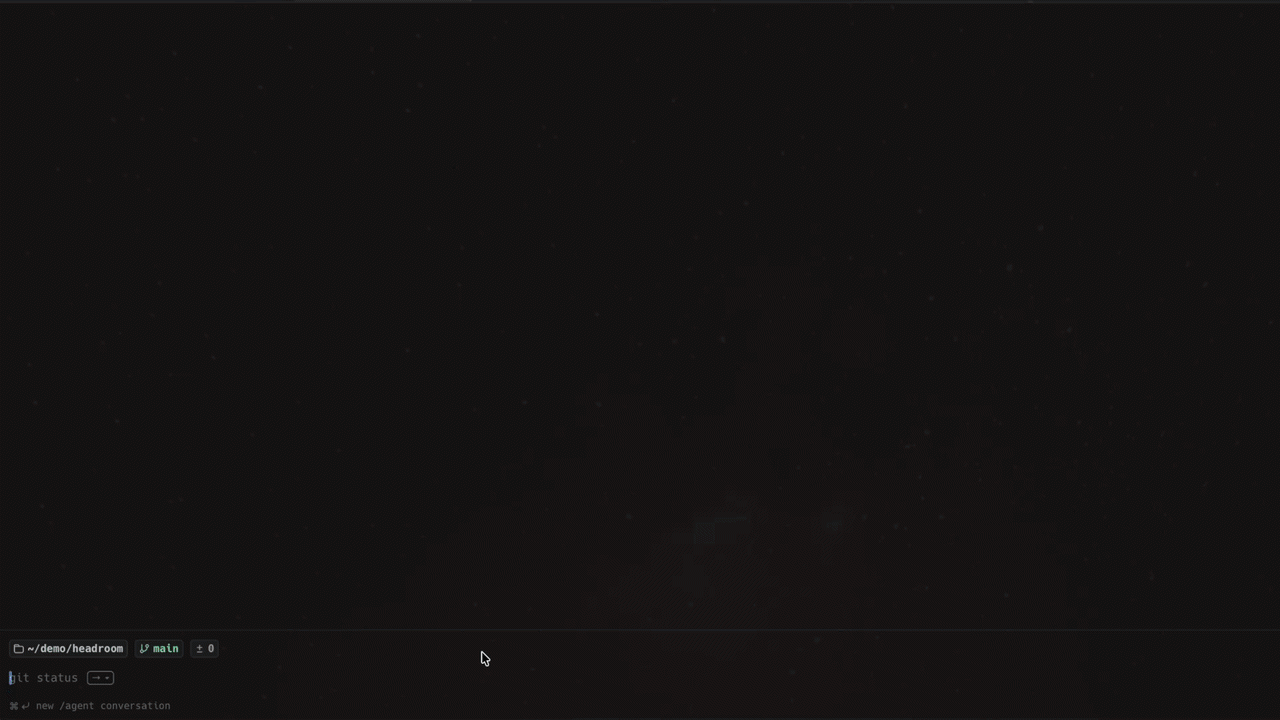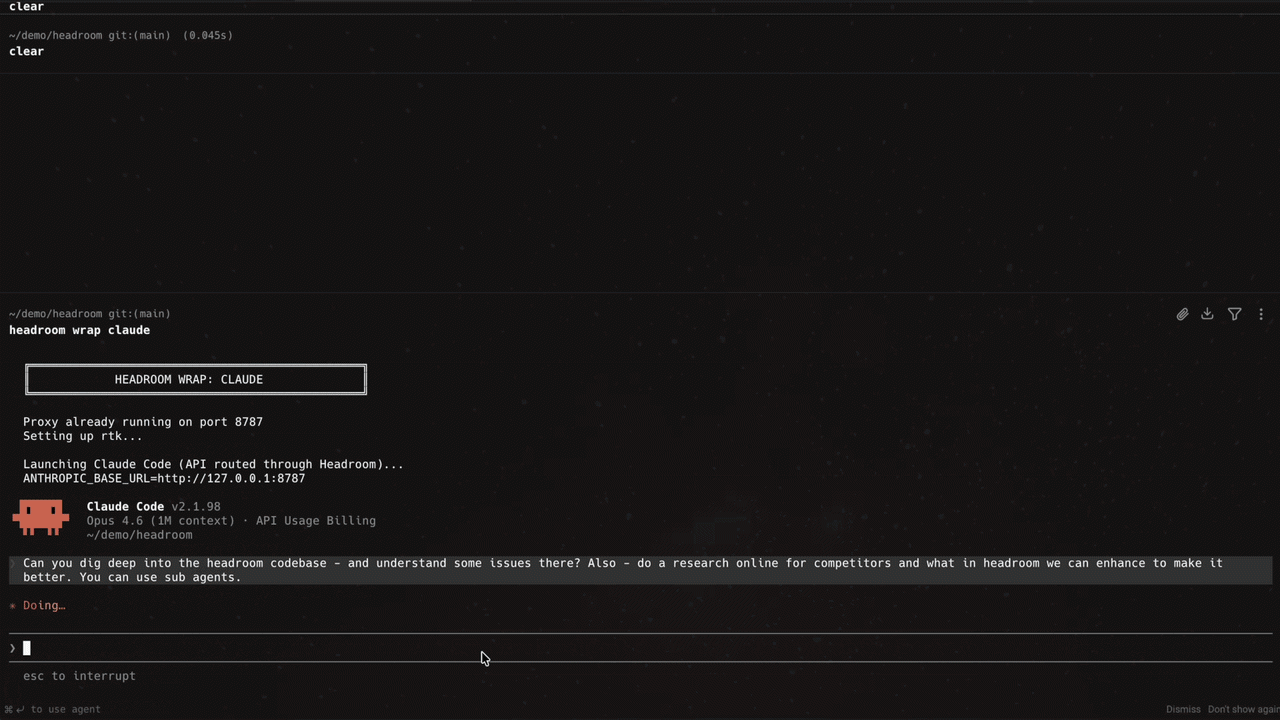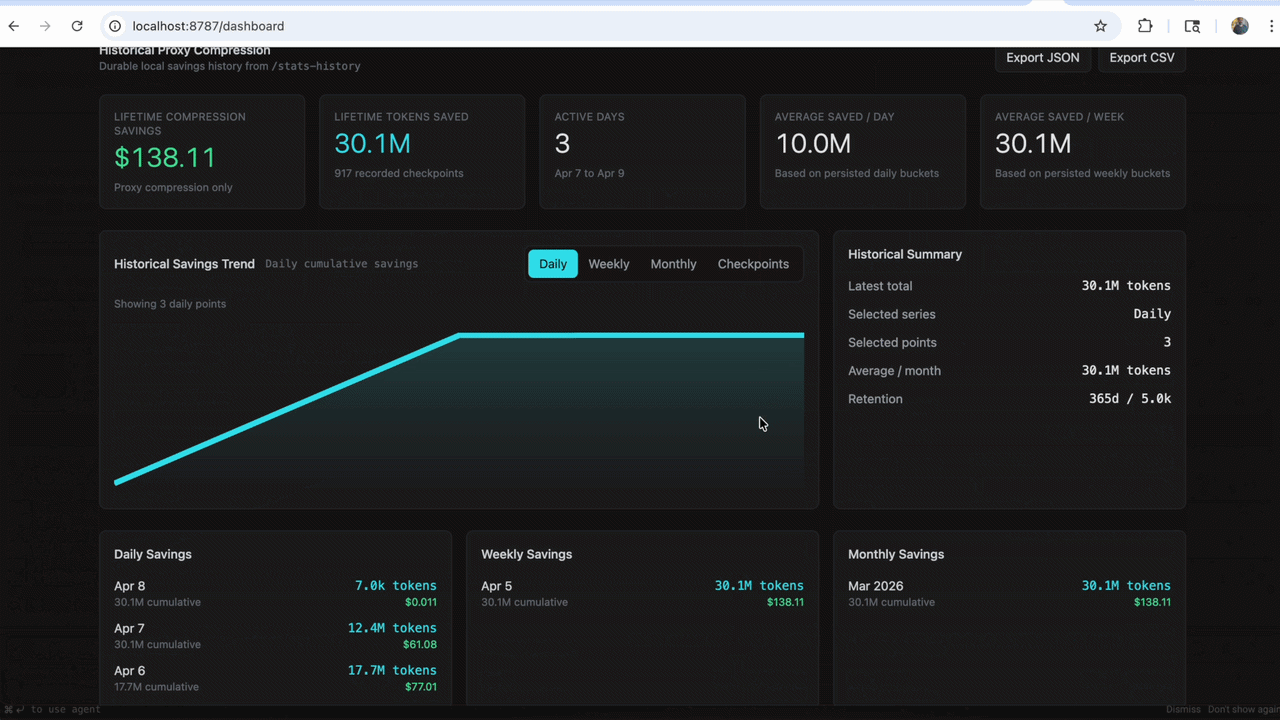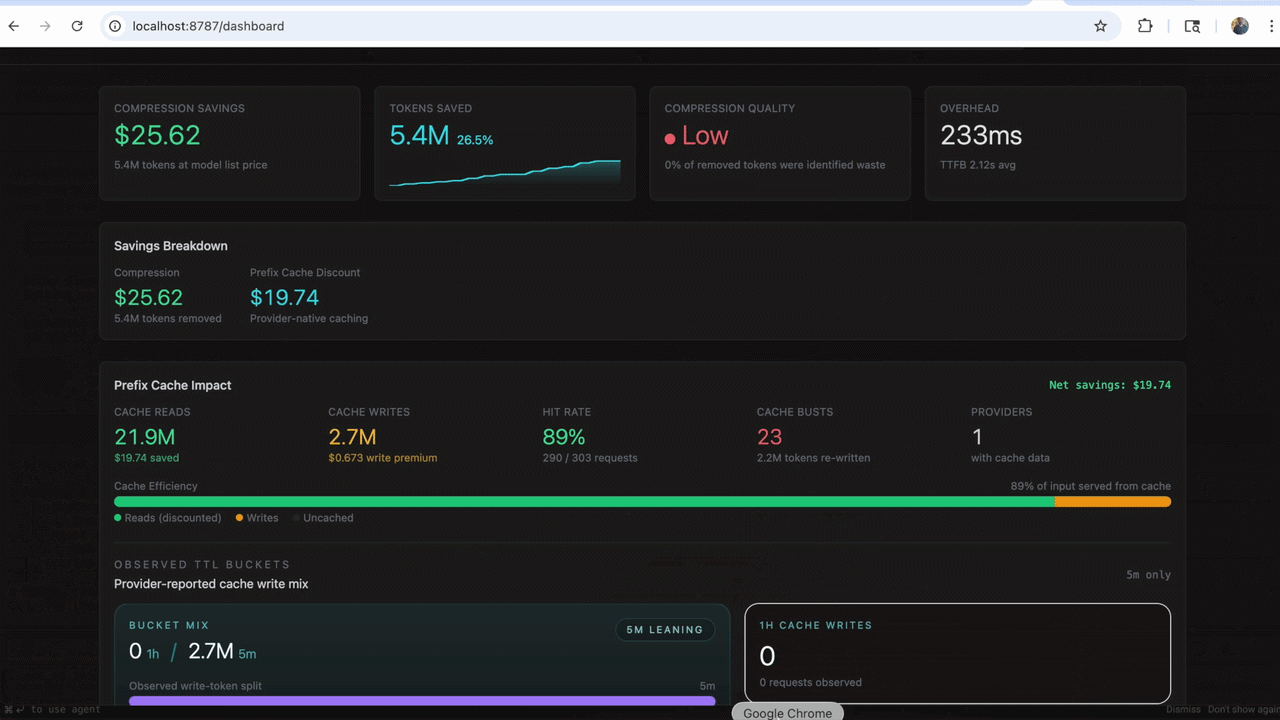
JSON 데이터는 60~95%, 코딩 에이전트 워크로드는 15~20%의 토큰 절감 효과를 제공한다. 코드 검색이나 SRE 인시던트 디버깅 같은 실제 작업에서 92%까지 토큰이 줄어드는 사례가 확인된다. Python과 TypeScript 라이브러리, 프록시, MCP 서버, 에이전트 래핑 등 다양한 방식으로 통합할 수 있다.
단순 압축이 아니라 원본을 로컬에 캐시해 필요 시 다시 가져올 수 있는 가역적 압축 방식을 채택했다. Claude, Codex, Gemini, Grok 등 여러 에이전트 간 메모리를 공유하고 중복을 제거한다. 실패한 세션을 분석해 교정 사항을 자동으로 기록하는 학습 기능도 포함된다.
입력 토큰만 줄이는 것이 아니라 모델이 작성하는 출력 토큰도 최적화한다. 불필요한 서론이나 코드 재인용을 제거하고, 루틴 단계에서는 추론 노력을 낮춘다. 로컬 우선 설계로 데이터가 외부로 나가지 않으며, Apache-2.0 라이선스로 공개되어 있다.
headroomlabs-ai/headroom
Compress tool outputs, logs, files, and RAG chunks before they reach the LLM. 20% fewer tokens for coding agents, 60-95% fewer tokens for JSON, same answers. Library, proxy, MCP server.
Python
이 한국어 소개글은 AI가 자동으로 만들었습니다. 원문의 주장과 맥락은 원문에서 확인해 주세요. 저작권은 원저작자에게 있습니다.