 AI Briefing
modlens: 텍스트 전용 LLM에 시각을, 이미지 붙여넣기만으로
liustack/modlens
프로젝트 소개
DeepSeek이나 GLM 같은 텍스트 전용 모델은 이미지를 직접 인식하지 못한다. ModLens는 이러한 모델에 시각 기능을 부여하는 플러그인 엔진으로, 채팅창에 이미지를 붙여넣기만 하면 된다. 파일을 저장하거나 경로를 전달하는 기존 방식과 달리, 이미지 경로가 자동으로 생성되어 즉시 처리된다.
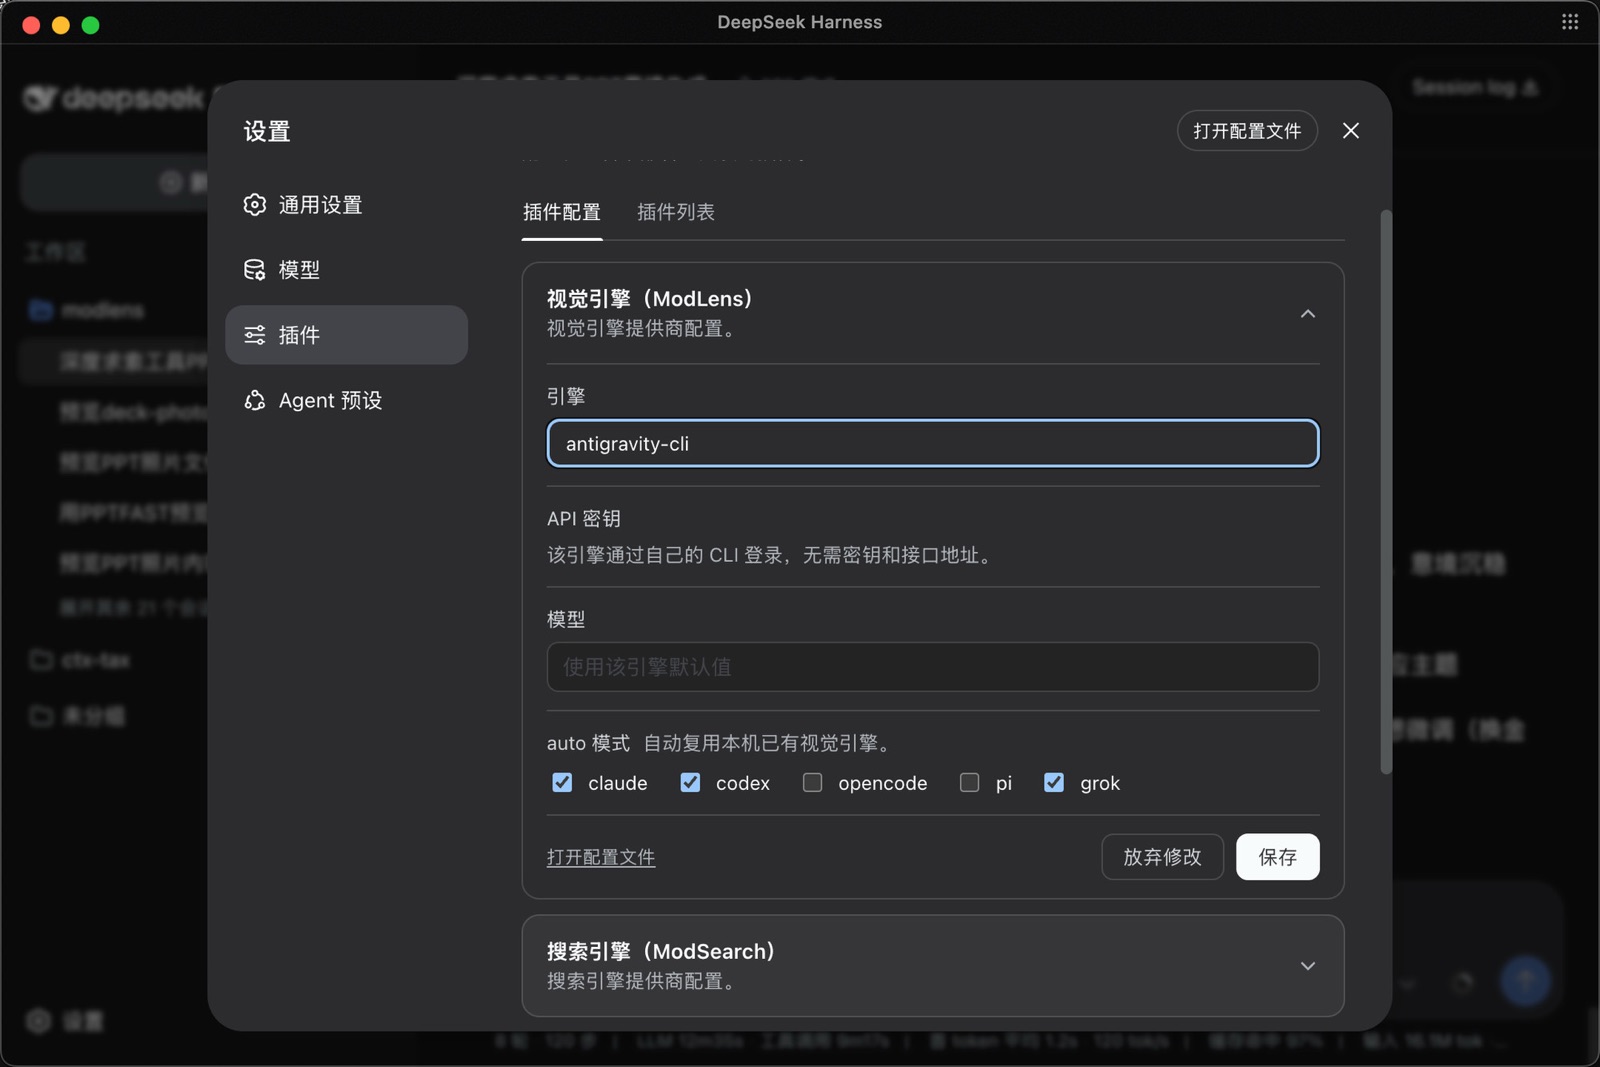
이미지 인식은 단순히 내용을 요약하는 것을 넘어, 전체 전사, 읽기 순서 기반 레이아웃 영역, 엔티티 및 관계 목록 등 구조화된 증거를 제공한다. 모델은 추측이 아닌 실제 읽은 내용을 근거로 답변을 생성한다. 한 번 붙여넣은 이미지에 대해 후속 질문을 할 때에도 다시 붙여넣을 필요가 없다.
특정 비전 서비스에 종속되지 않도록 10가지 소스를 지원한다. Gemini, OpenAI, Anthropic 등 6개의 내장 제공자와 Claude Code, Codex, OpenCode, Pi 등 로컬 에이전트 CLI 4개를 포함한다. 기존에 로그인된 CLI의 크레덴셜을 재사용할 수 있으며, 모든 재사용 읽기는 누가 쿼터를 소모했는지 명확히 기록된다.
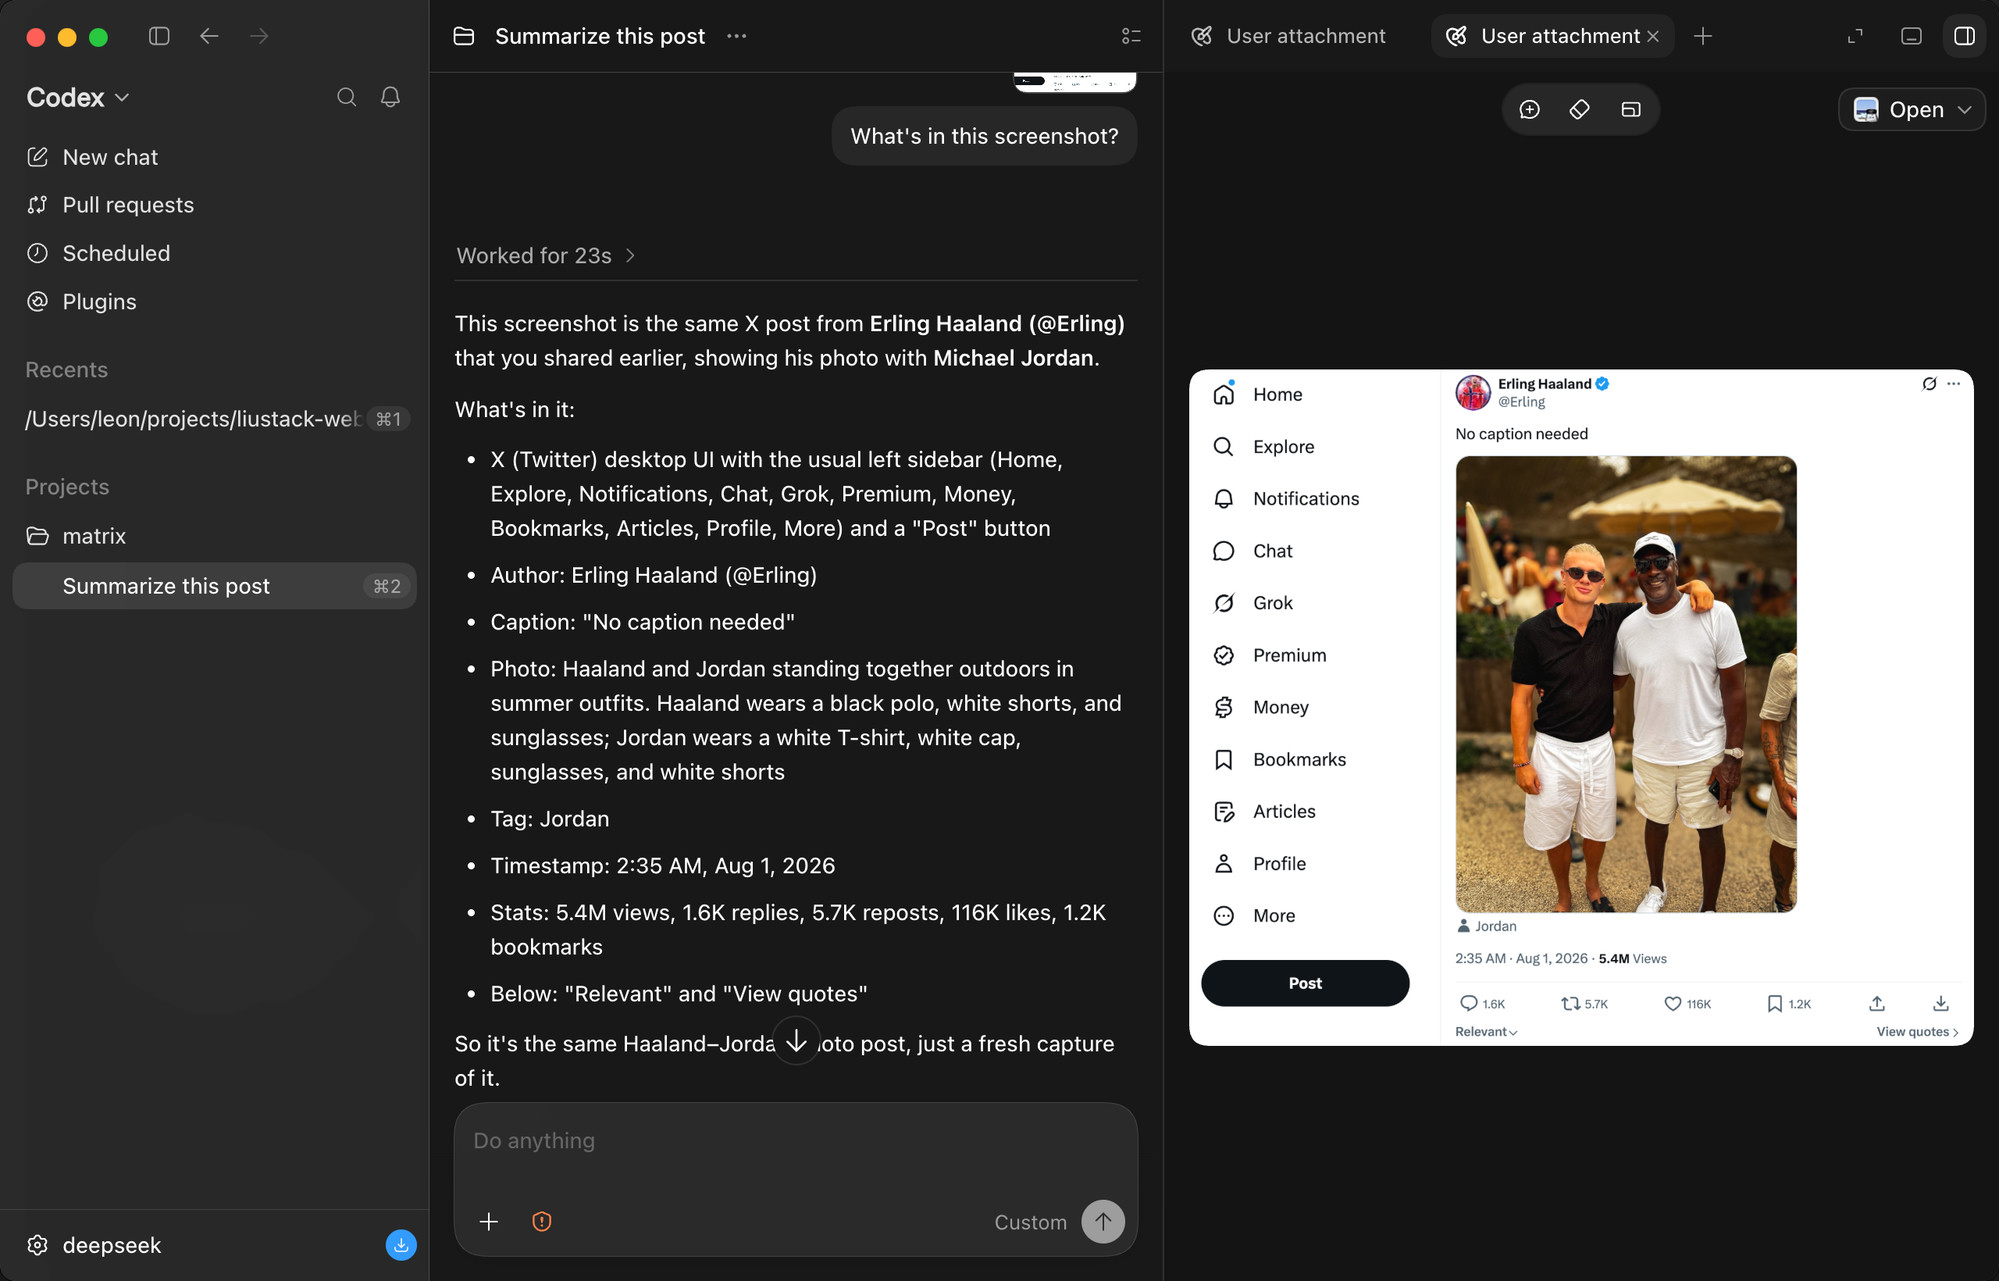
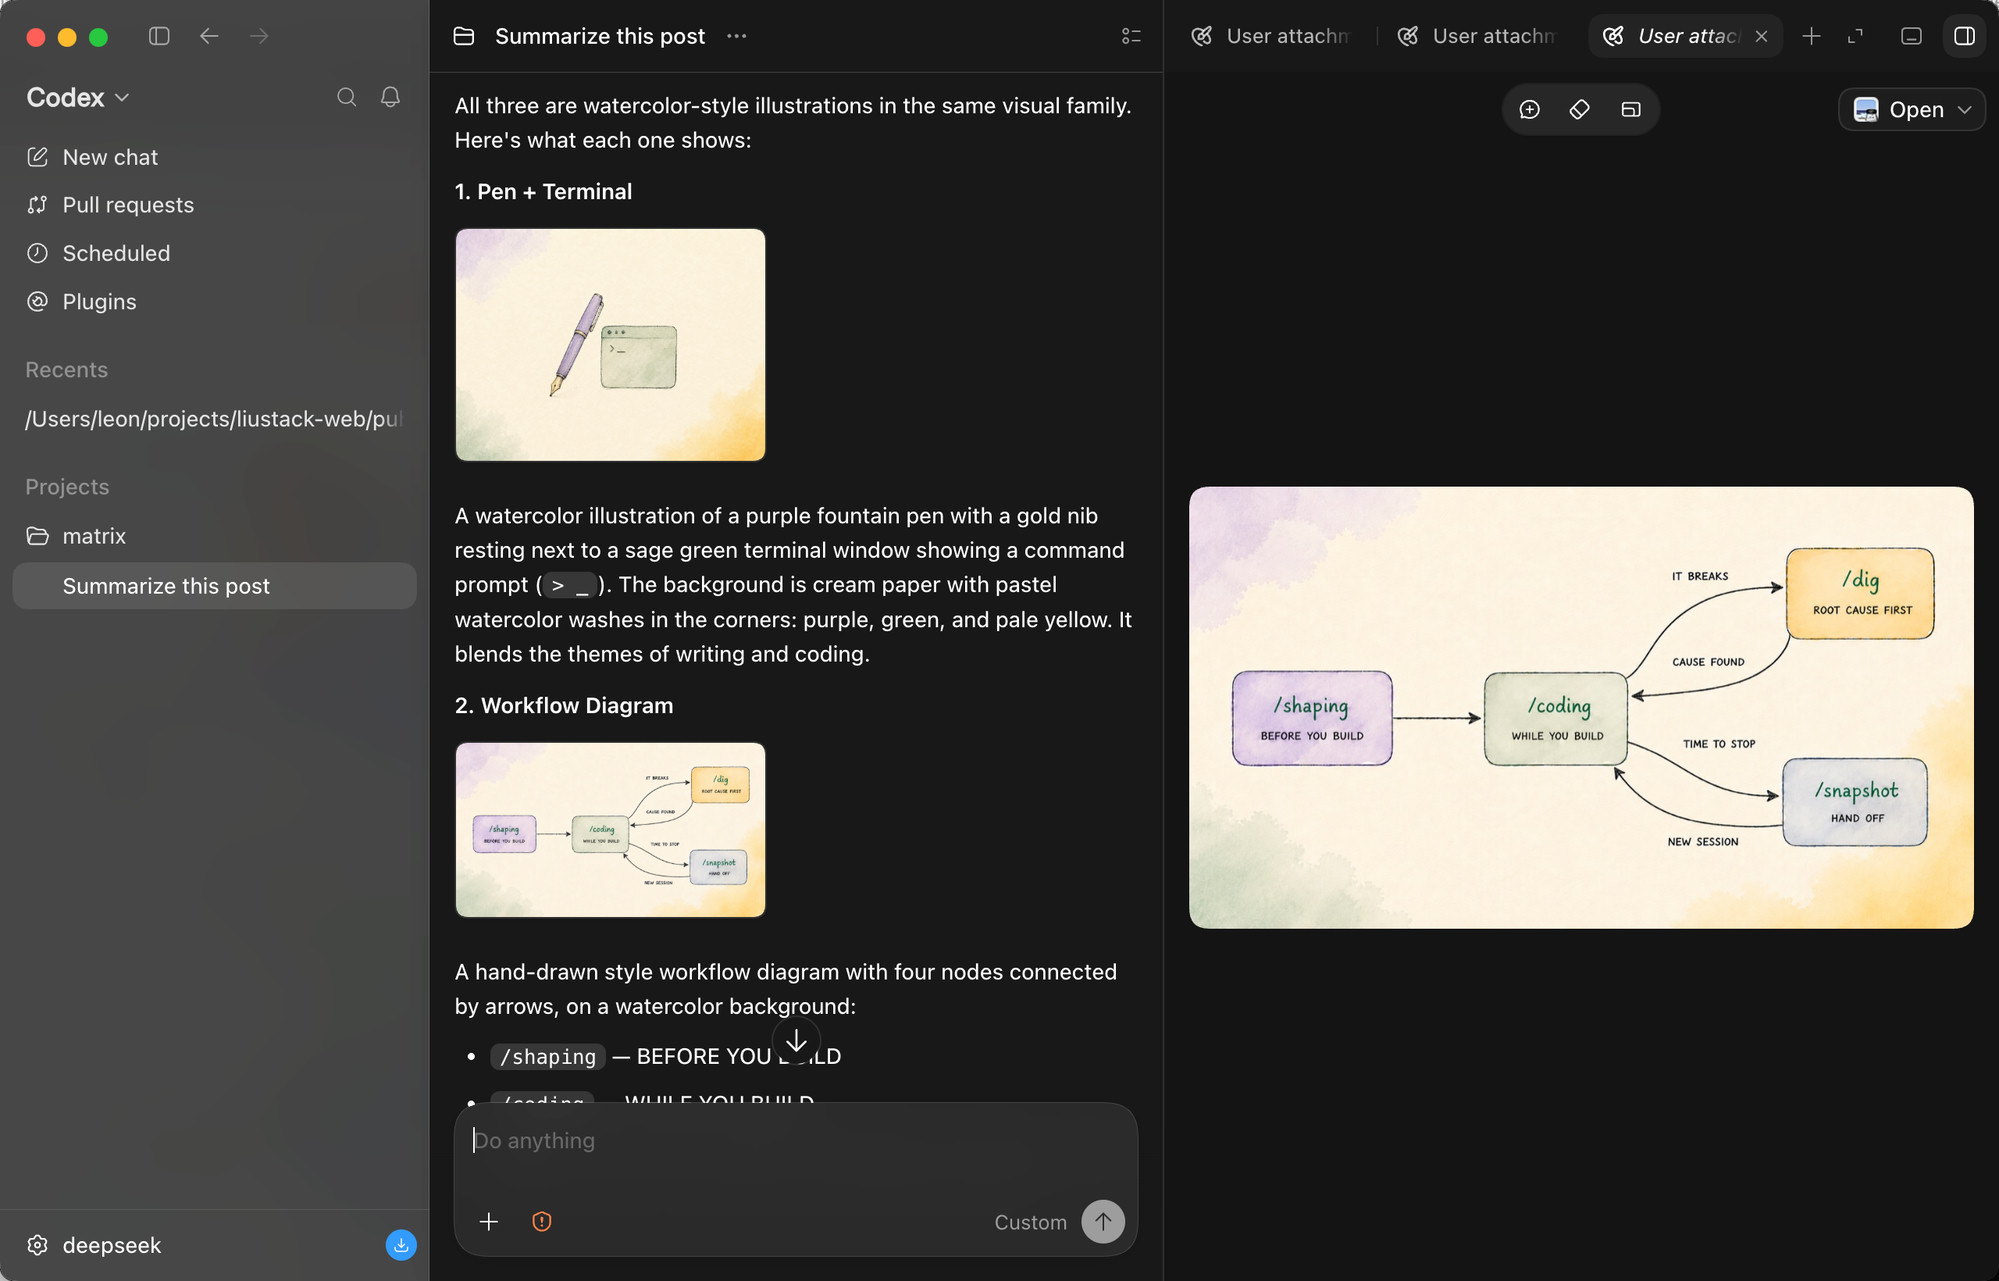
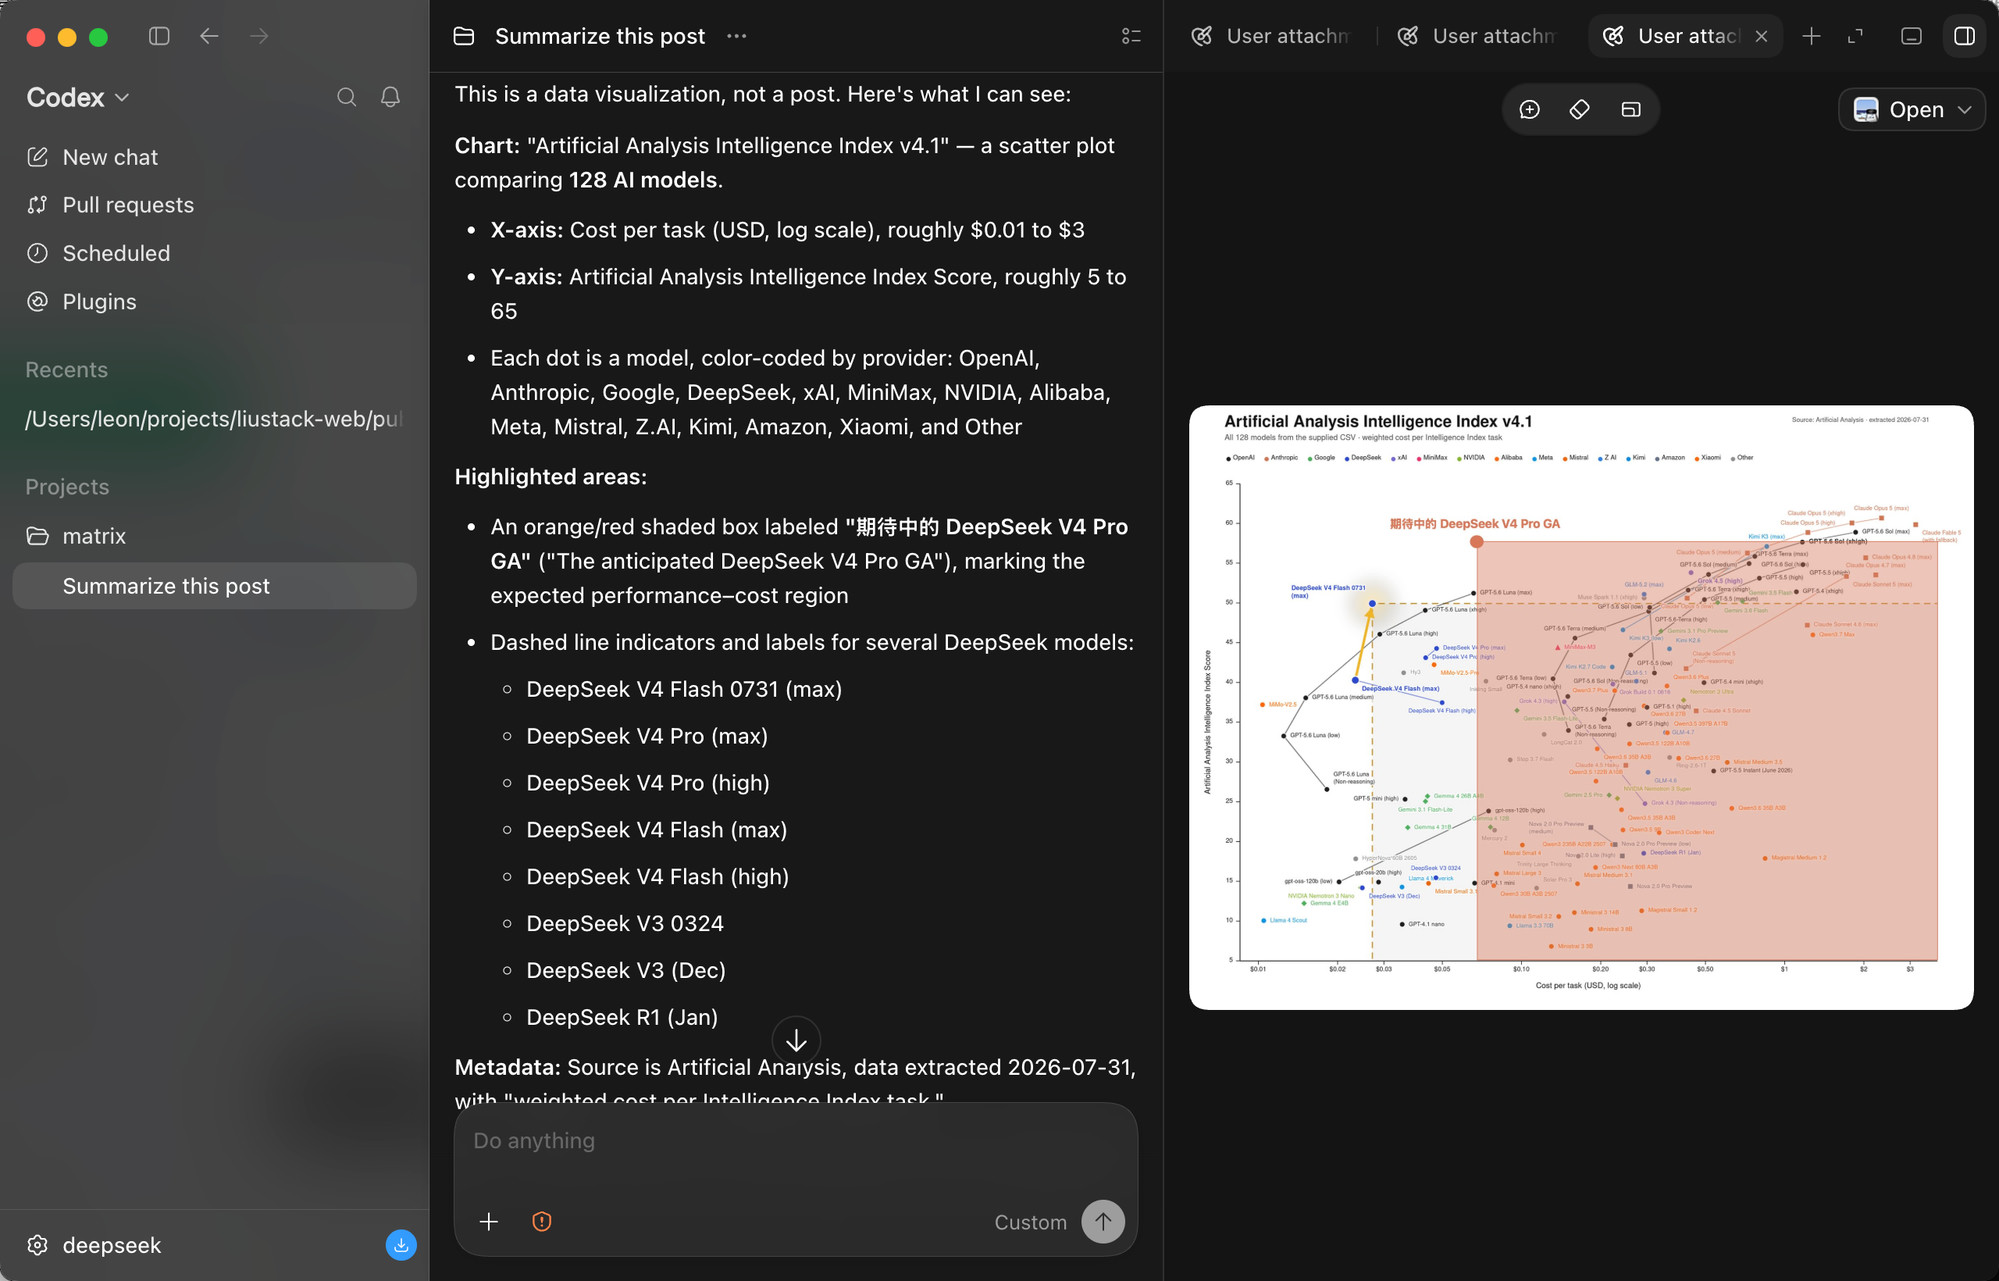
설치와 제거가 단순하여 기존 에이전트 설정에 영향을 주지 않는다. 스킬 하니스에서는 단일 폴더, dsh에서는 단일 플러그인으로 동작하며, 폴더만 삭제하면 원래 상태로 복귀한다. Claude Code, Codex, Pi, OpenCode 등 다양한 환경에서 검증되어, 텍스트 전용 모델을 사용하는 개발자가 이미지 기반 작업을 수행할 때 유용하다.
liustack/modlens
The first vision plugin for DeepSeek Harness, and the vision bridge for every text-only coding agent. Paste an image, get structured JSON evidence (OCR, layout, semantics). | 全网最强 DeepSeek Harness 外挂视觉插件,为 DeepSeek、GLM 等纯文本模型外挂视觉能力,粘贴图片即得结构化 JSON 证据(OCR、版面、语义)。
TypeScript
이 한국어 소개글은 AI가 자동으로 만들었습니다. 원문의 주장과 맥락은 원문에서 확인해 주세요. 저작권은 원저작자에게 있습니다.