 AI Briefing
laya-mlx: Apple Silicon에서 7ms 만에 끝나는 로컬 분류 추론
mizorewww/laya-mlx
프로젝트 소개
LLM의 토큰 생성 없이 선택지 분류나 점수 매기기 같은 구조화된 결정을 내리는 추론 엔진이다. 양방향 인코더를 활용해 입력 상태와 질문을 한 번의 순방향 패스로 처리하며, 기존 생성형 모델이 겪는 지연과 불확실성을 제거한다.
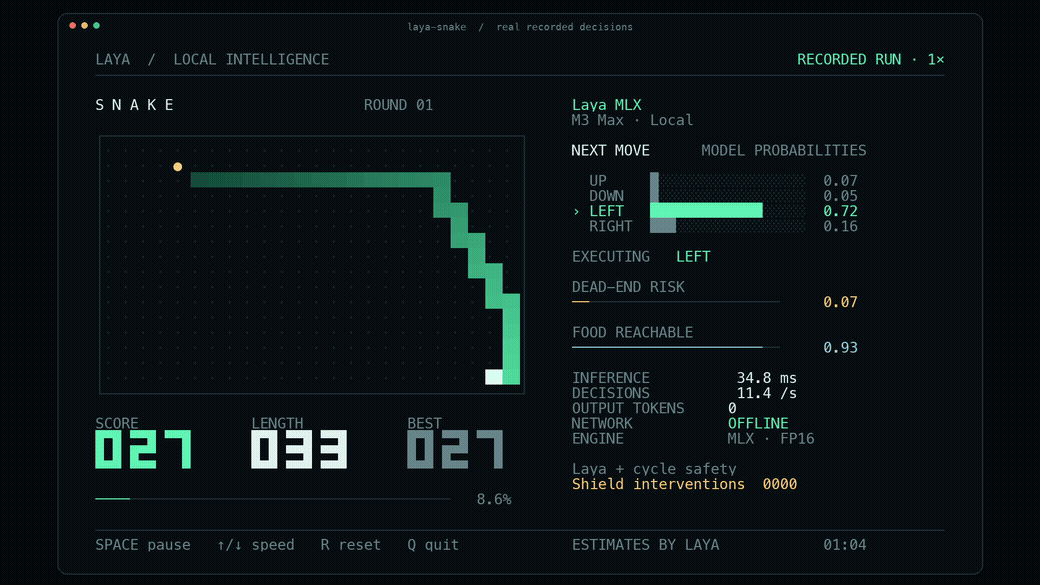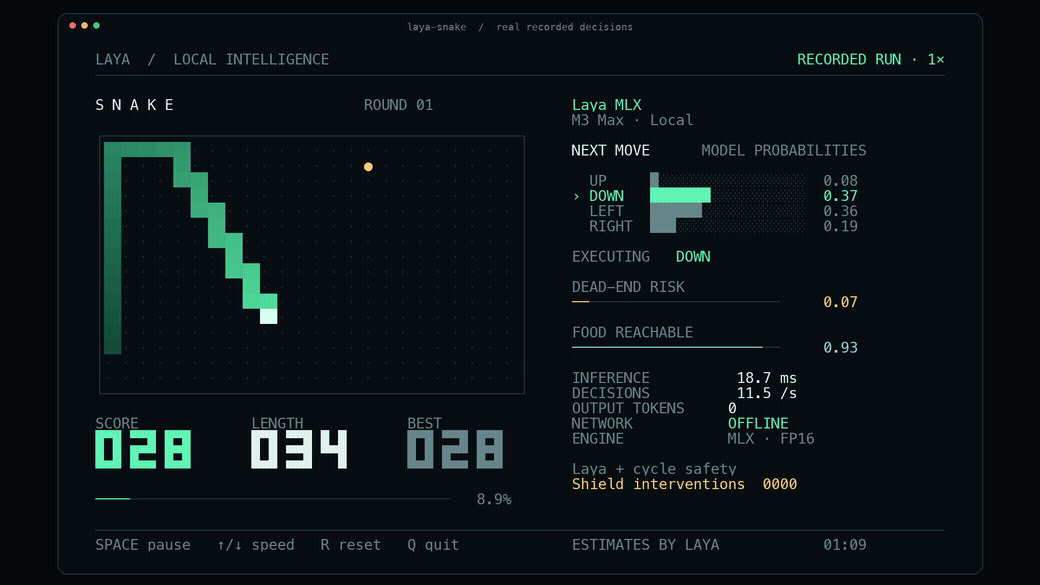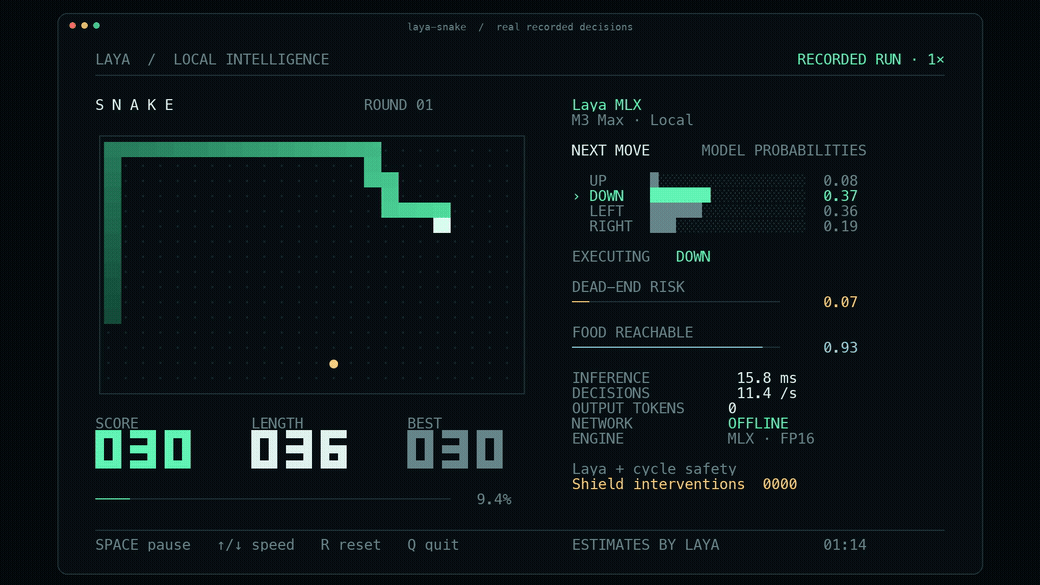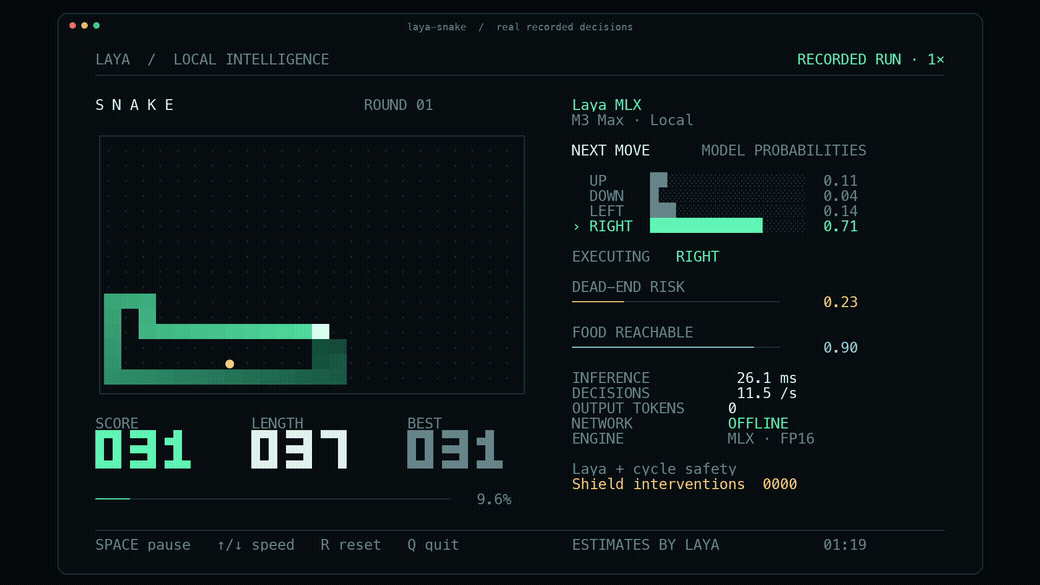
M3 Max 기준 영어 질문 처리 시 중위도 13.4ms, 다국어 모델은 7.4ms의 초저지연을 기록한다. PyTorch나 Transformers 런타임 없이 MLX 네이티브로 구동되어 클라우드 API 호출 없이 로컬에서 즉시 응답한다.
선택지 중 하나를 고르는 choice, 루브릭 점수를 매기는 score, 참/거짓 확률을 반환하는 noul 세 가지 작업 유형을 지원한다. 라우터 기능을 통해 입력 언어에 따라 영어 전용 모델과 다국어 모델을 자동으로 분기하여 최적의 성능을 낸다.
실시간 분류가 필요한 에이전트 워크플로우나 오프라인 환경에서 경량 추론이 요구되는 애플리케이션에 적합하다. Convai Innovations의 원본 가중치를 유지하면서도 Apple Silicon 하드웨어에 최적화된 독립 포트다.
mizorewww/laya-mlx
Native MLX runtime for Laya typed decision models — 7–14 ms short decisions on M3 Max. No text generation, PyTorch, or cloud API.
Python
이 한국어 소개글은 AI가 자동으로 만들었습니다. 원문의 주장과 맥락은 원문에서 확인해 주세요. 저작권은 원저작자에게 있습니다.