 AI Briefing
Qwen3.8-27B-DFlash2: Qwen3.8-27B 추론 속도 3.4배 끌어올리는 드래프트 모델
incoai/Qwen3.8-27B-DFlash2
프로젝트 소개
Qwen3.8-27B의 추론 속도를 높이기 위한 DFlash 2 드래프트 모델이다. 단독으로 동작하는 언어 모델이 아니라, SGLang이나 vLLM 같은 추론 서버 내부에서 speculative decoding을 수행하며 타겟 모델이 검증할 토큰을 미리 작성하는 역할을 한다. Apache-2.0 라이선스로 공개되어 있으며, 2B 파라미터 크기의 BF16 체크포인트로 제공된다.
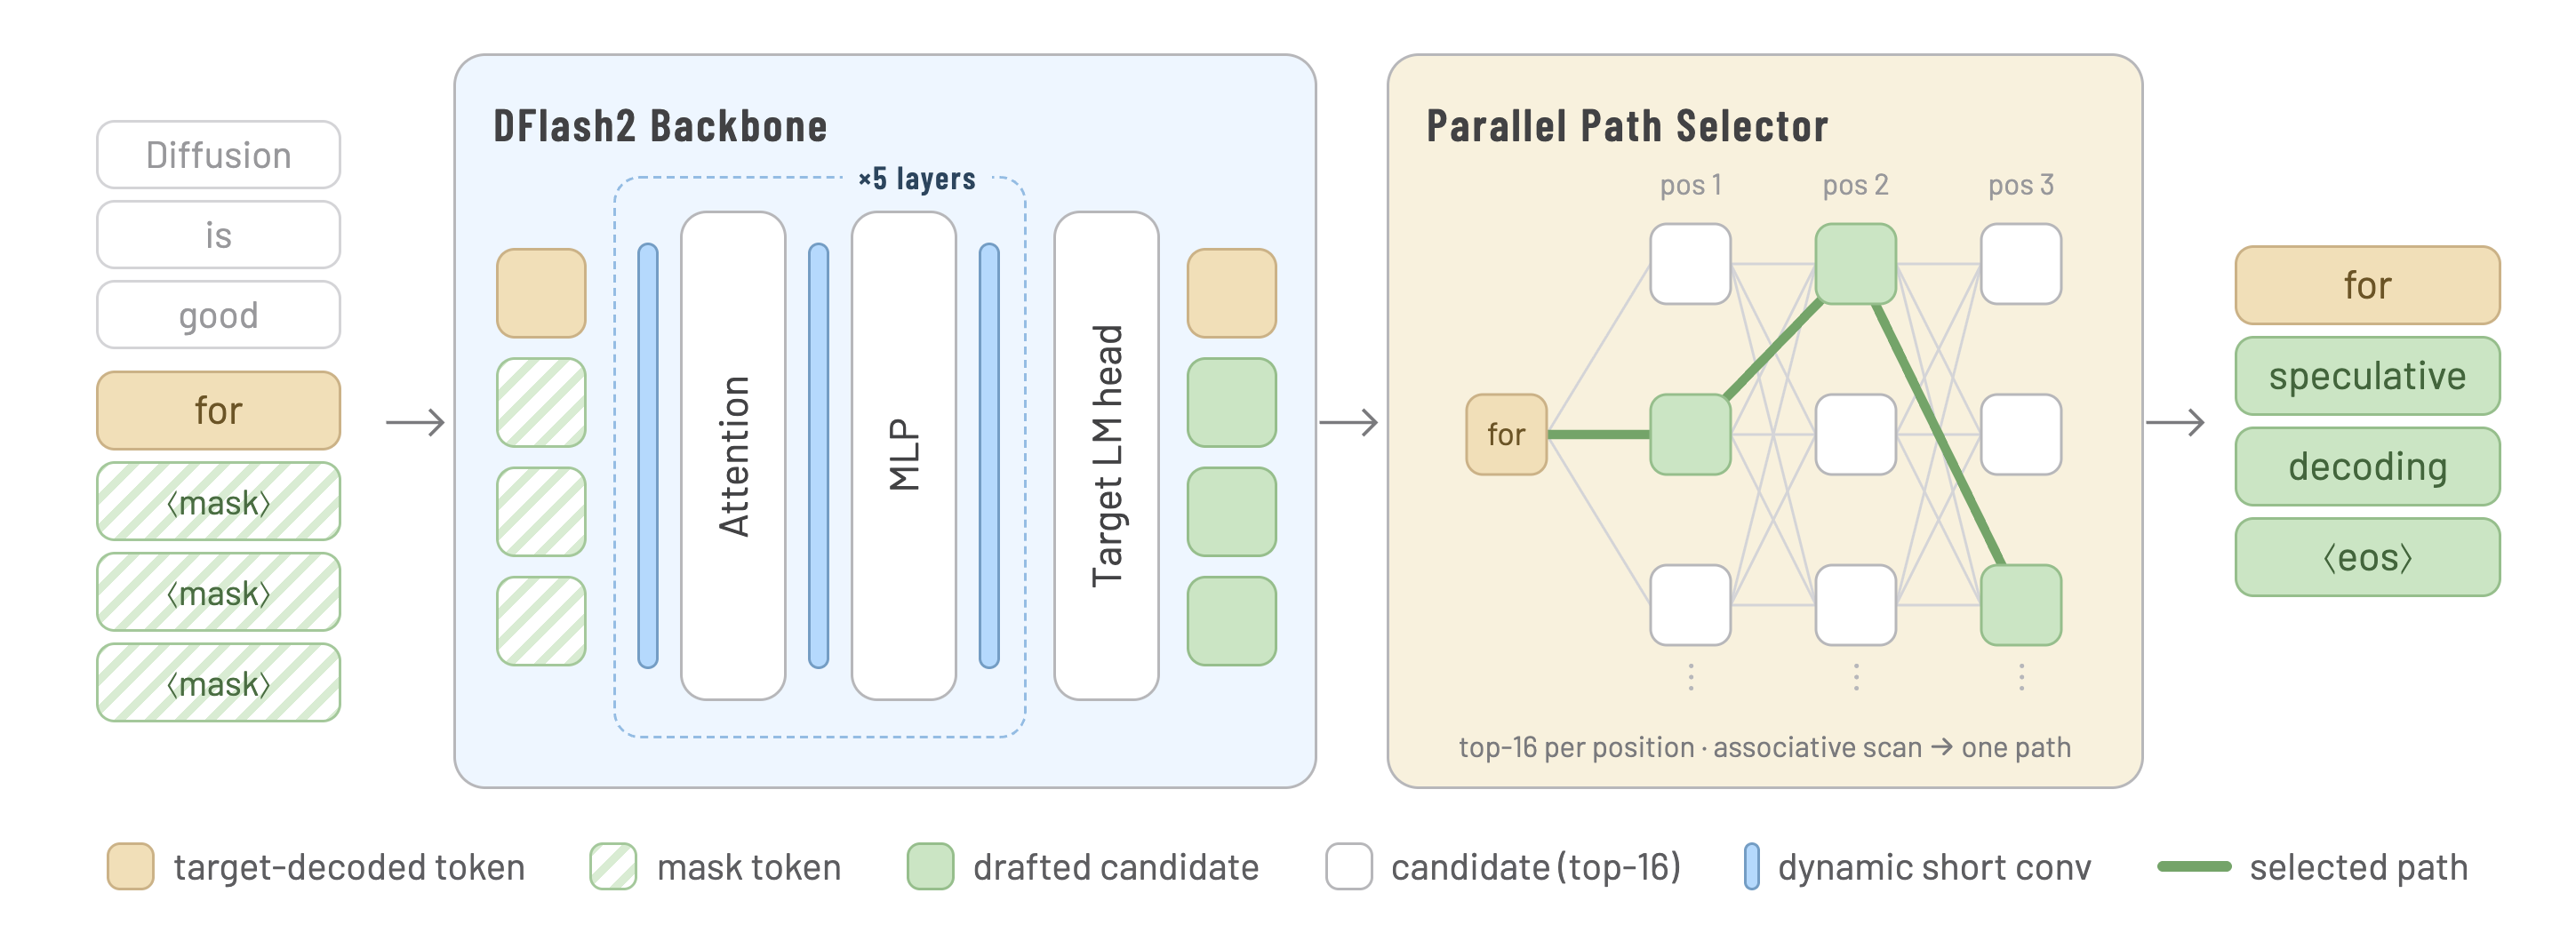
기존 방식과 달리 블록 확산(block-diffusion) 기법을 활용해 한 번의 패스에서 토큰 블록 전체를 예측한다. 백본에 두 탭 동적 합성을 적용해 블록 후반부로 갈수록 드래프트 품질이 떨어지는 현상을 방지한다. 이 과정은 손실 없이 진행되어 그리디 출력은 타겟 모델과 정확히 일치하고, 샘플링 시에도 원래 분포를 유지한다.
NVIDIA H200 단일 GPU 환경에서 SGLang을 이용해 측정한 결과, 오토레그레시브 디코딩 대비 최대 3.43배의 처리량 향상이 확인됐다. GSM8K, MATH-500, HumanEval 등 주요 벤치마크에서 내장 MTP나 다른 커뮤니티 드래프트 모델보다 높은 수용 길이(acceptance length)를 기록했다. 특히 동시 요청 1건일 때 속도 이점이 가장 크게 나타난다.
대규모 언어 모델의 응답 지연 문제를 해결하고 싶은 개발자에게 적합하다. 기존 Qwen3.8-27B를 서비스 중인 환경에 드래프트 모델 경로를 지정하는 것만으로 적용할 수 있어, 별도 파인튜닝이나 복잡한 설정 변경 없이 추론 효율을 개선할 수 있다.
incoai/Qwen3.8-27B-DFlash2
원문에 등록된 설명이 없습니다.
text-generation
이 한국어 소개글은 AI가 자동으로 만들었습니다. 원문의 주장과 맥락은 원문에서 확인해 주세요. 저작권은 원저작자에게 있습니다.