 AI Briefing
AuK: 자연어 지시 하나로 음성 생성·편집·분리까지
tencent/AuK
·2026.09.12 23:40
프로젝트 소개
Tencent가 공개한 1.5B 파라미터 기반의 음성 생성 및 편집 파운데이션 모델이다. 수백만 시간의 오디오 데이터로 학습되어, 별도의 복잡한 설정 없이 자연어 지시문 하나로 다양한 음성 작업을 수행한다.
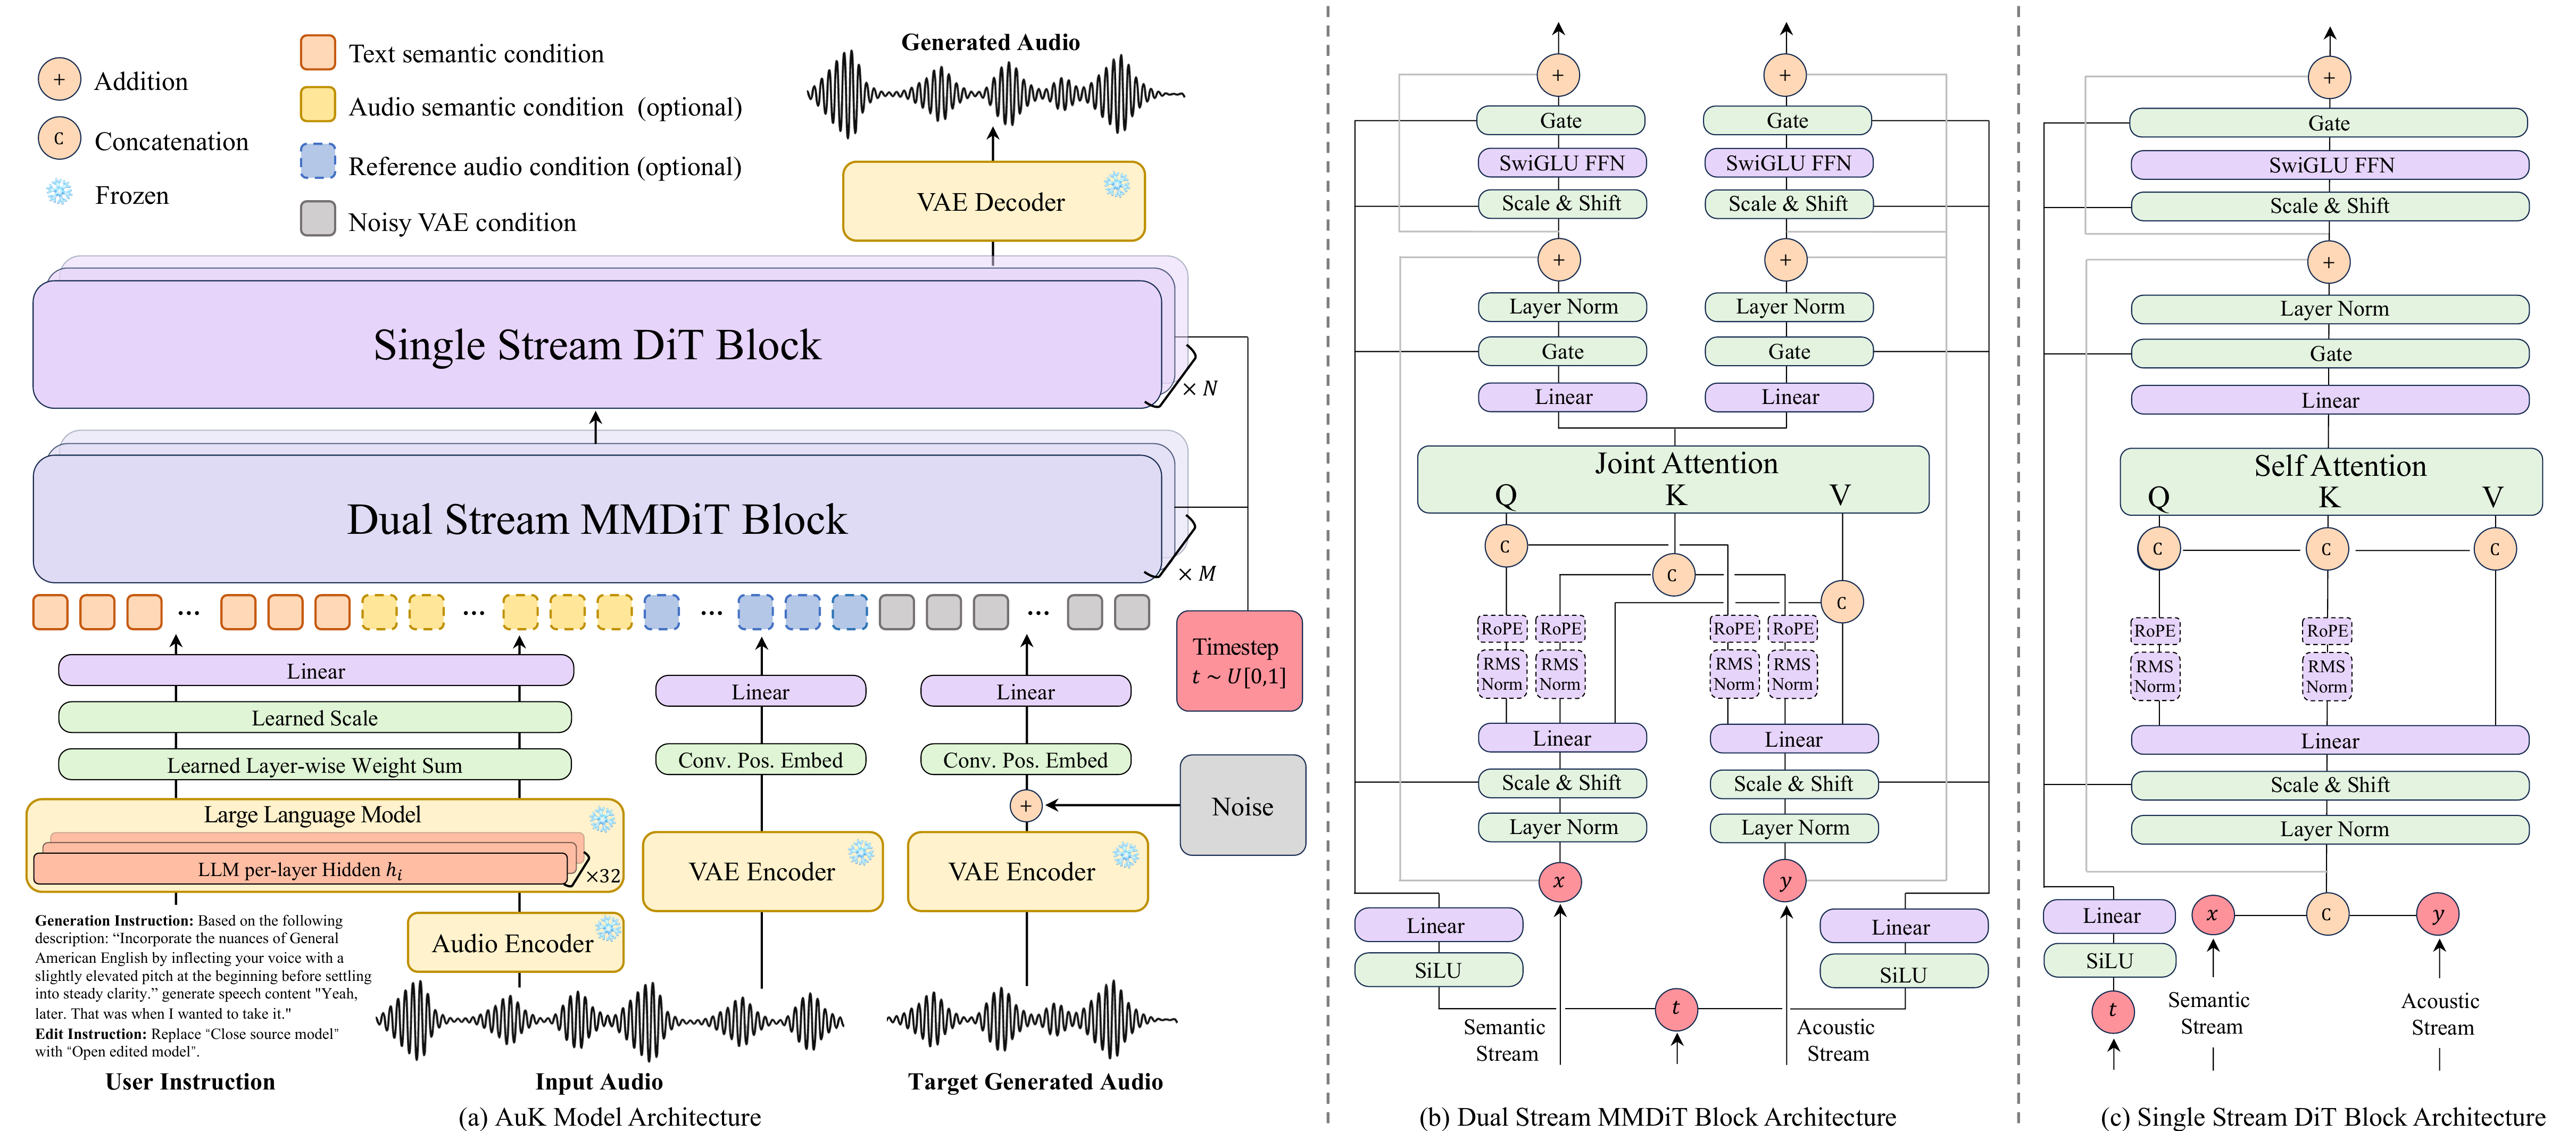
참조 음성 기반의 Zero-shot TTS부터 목소리 묘사만으로 생성하는 Instruct TTS까지 지원한다. 이미 생성된 음성의 감정, 억양, 속도, 볼륨을 수정하거나 비언어적 소리를 제거하는 등 세밀한 편집이 가능하다.
음성 향상, 화자 분리, 음악에서 보컬 추출 등 오디오 처리 기능도 통합되어 있다. 기본 모델과 4단계 추론으로 속도를 높인 AuK-Flash 변형이 제공되며, MIT 라이선스로 상용화 제한이 없다.
HuggingFace 모델
tencent/AuK
원문에 등록된 설명이 없습니다.
text-to-speech
이 한국어 소개글은 AI가 자동으로 만들었습니다. 원문의 주장과 맥락은 원문에서 확인해 주세요. 저작권은 원저작자에게 있습니다.