 AI Briefing
추천Qwen3.8-Flash-Next-GGUF: 72GB GGUF로 로컬에서 돌리는 Qwen3.8-Flash-Next
unsloth/Qwen3.8-Flash-Next-GGUF
프로젝트 소개
Unsloth가 Qwen3.8-Flash-Next 모델을 GGUF 포맷으로 변환해 배포했다. 이미지와 텍스트를 함께 이해하는 멀티모달 LLM으로, 로컬 환경에서 추론을 수행할 수 있도록 설계되었다. 총 용량은 약 72GB로, UD-IQ1_S 양자화 버전을 제공한다.
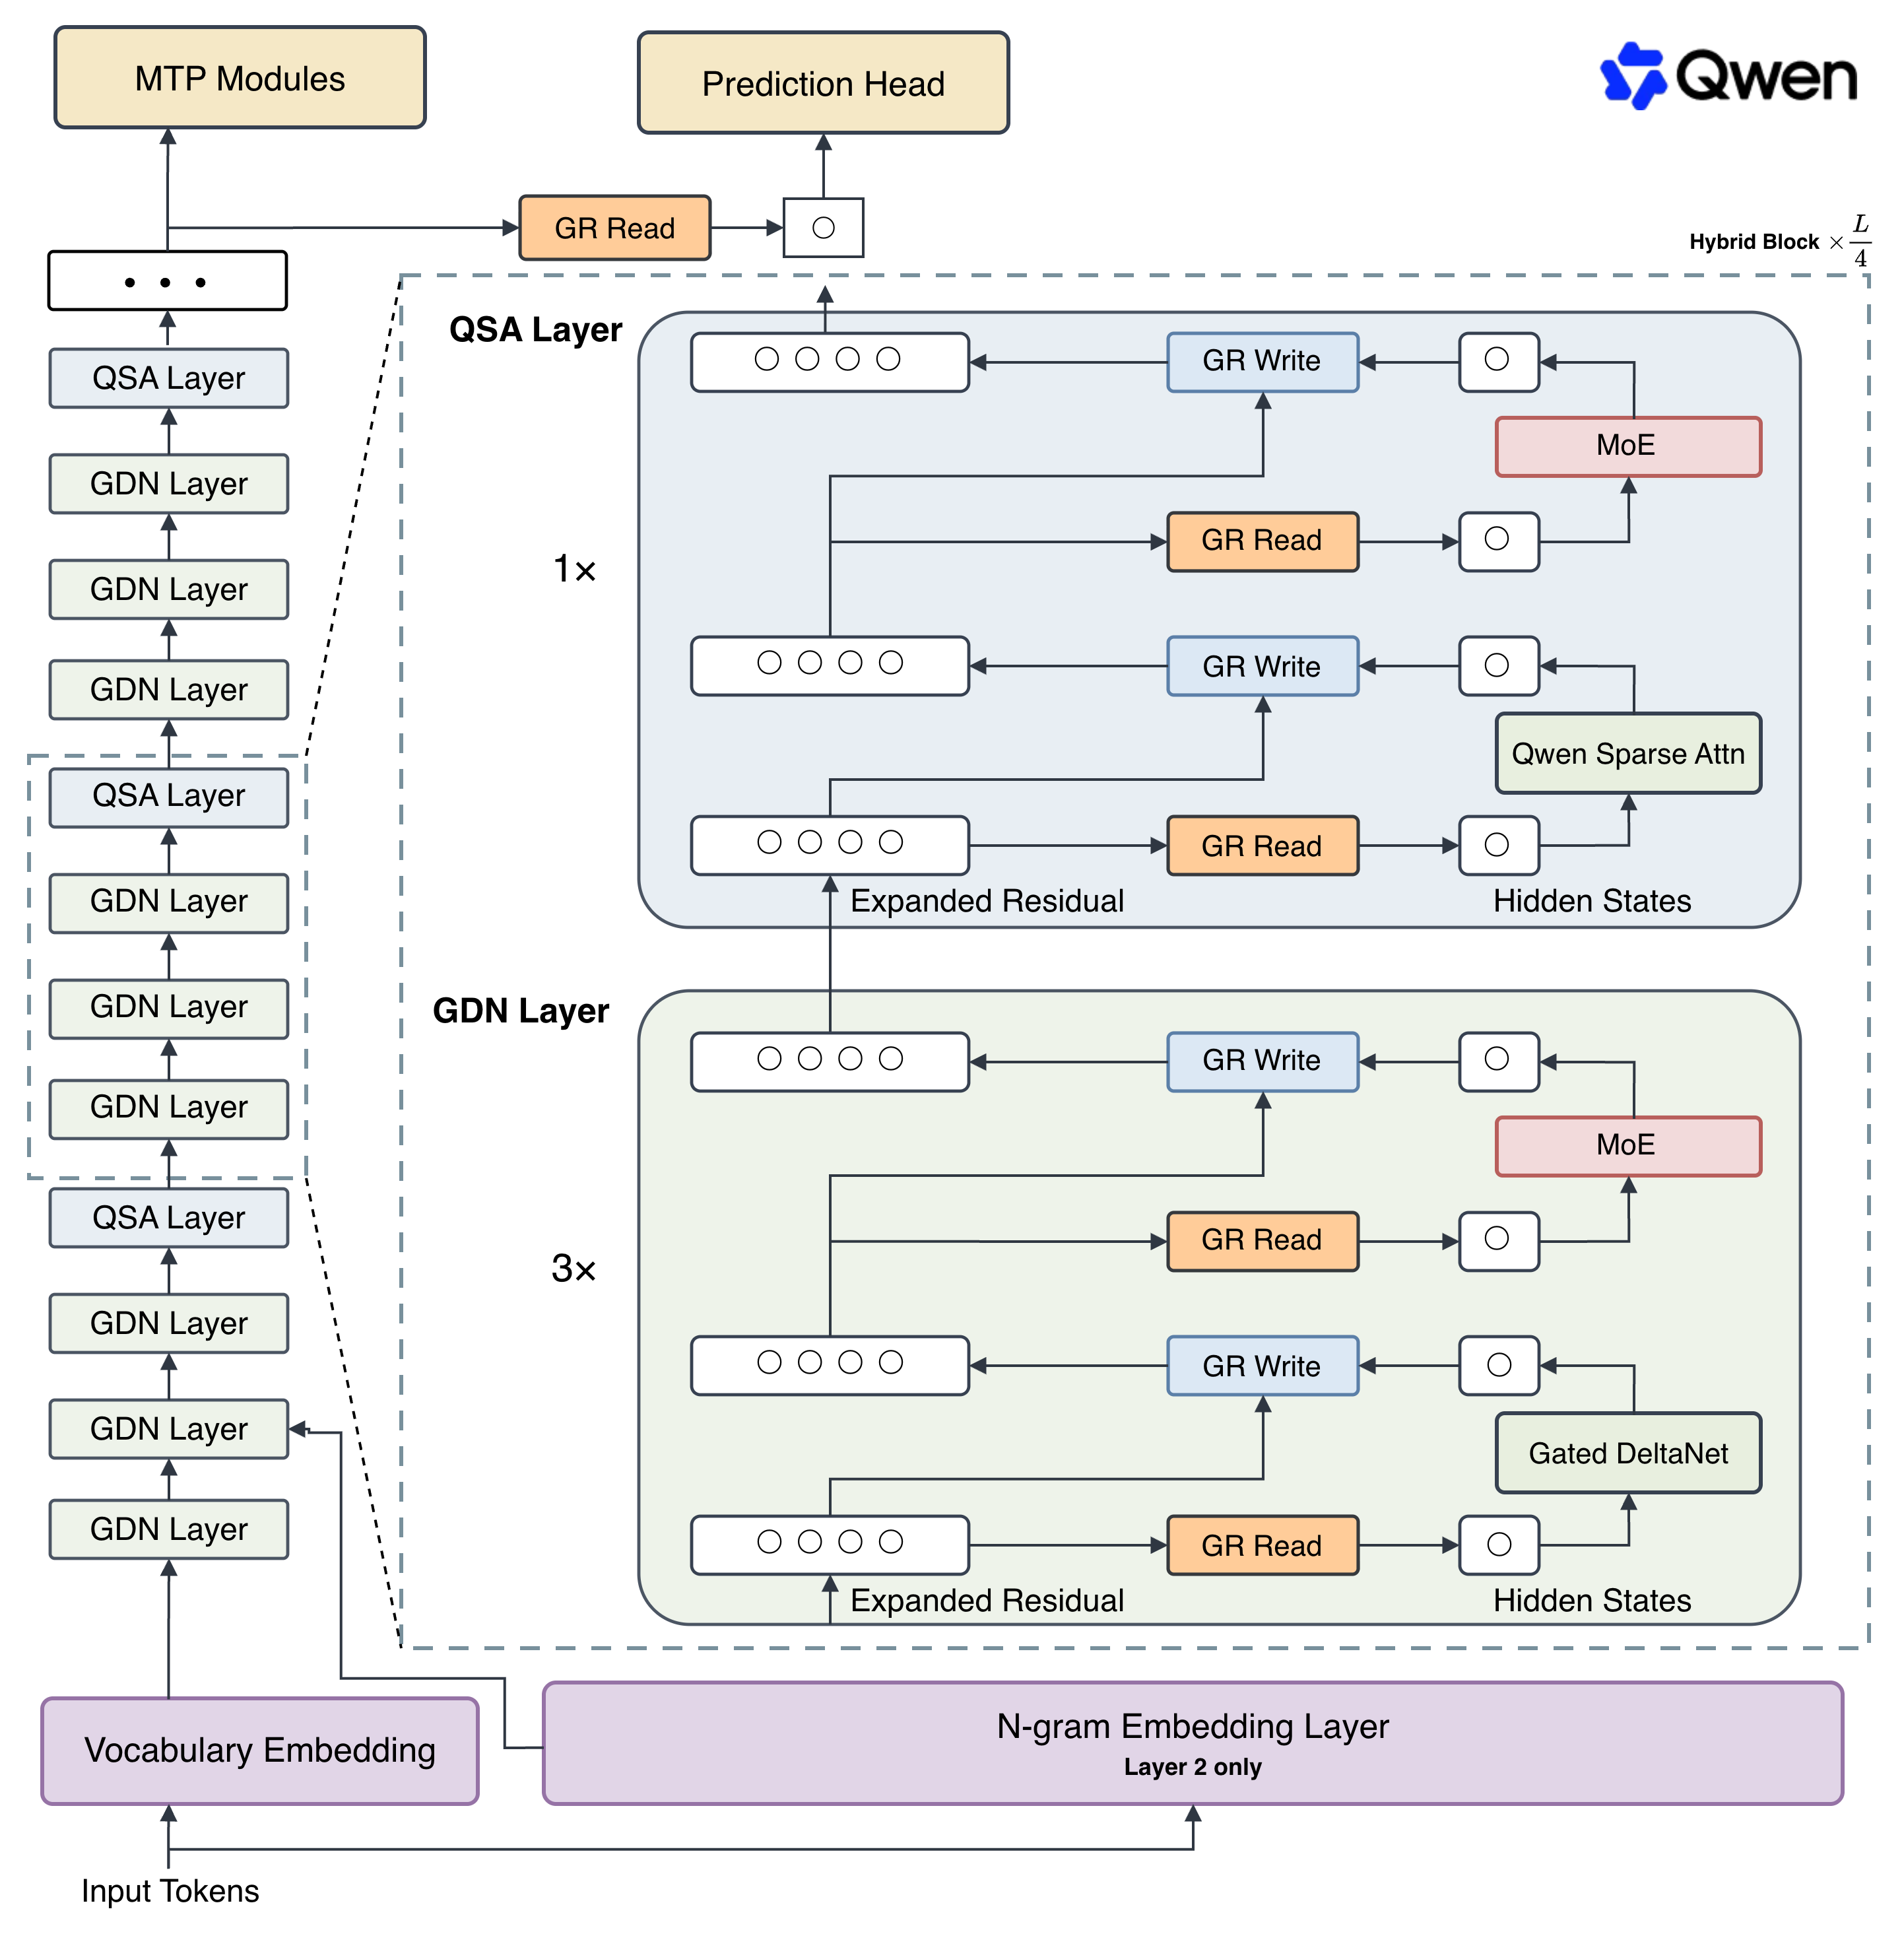
llama.cpp, vLLM, LM Studio 등 주요 로컬 추론 프레임워크와 호환된다. OpenAI 호환 API 서버를 띄우거나 터미널에서 직접 클라이언트로 실행할 수 있어, 클라우드 의존 없이 자체 인프라에서 모델을 구동하는 개발자에게 적합하다. Transformers 라이브러리와의 통합도 지원한다.
채팅 템플릿에 도구 호출(tool calling) 및 추론(reasoning) 지시 처리 로직이 포함되어 있다. 시스템 메시지 병합, 개발자 역할 지원, 멀티스텝 도구 호출 구조를 템플릿 레벨에서 처리해 에이전트 기반 애플리케이션 개발 시 프롬프트 엔지니어링 부담을 줄여준다.
Qwen 커뮤니티 라이선스 하에 공개되어 상업적 활용 전 조건 확인이 필요하다. 72GB라는 상당한 용량 때문에 고사양 GPU 환경이 요구되며, 로컬에서 대규모 멀티모달 모델을 실험하거나 프라이버시 보호가 필요한 추론 작업을 수행할 때 유용하다.
unsloth/Qwen3.8-Flash-Next-GGUF
원문에 등록된 설명이 없습니다.
image-text-to-text
이 한국어 소개글은 AI가 자동으로 만들었습니다. 원문의 주장과 맥락은 원문에서 확인해 주세요. 저작권은 원저작자에게 있습니다.