 AI Briefing
추천GLM-5.3-Flash: Terminal-Bench 84.3점, 36 TPS 속도의 GLM-5.3-Flash
zai-org/GLM-5.3-Flash
·2026.08.27 02:08
프로젝트 소개
zai-org가 공개한 GLM-5.3-Flash는 텍스트 생성 및 도구 호출을 지원하는 LLM이다. Hugging Face에서 라이브 추론이 가능하며, 초당 36.12 토큰의 처리 속도를 보인다. 모델 크기는 500B 미만으로 분류된다.
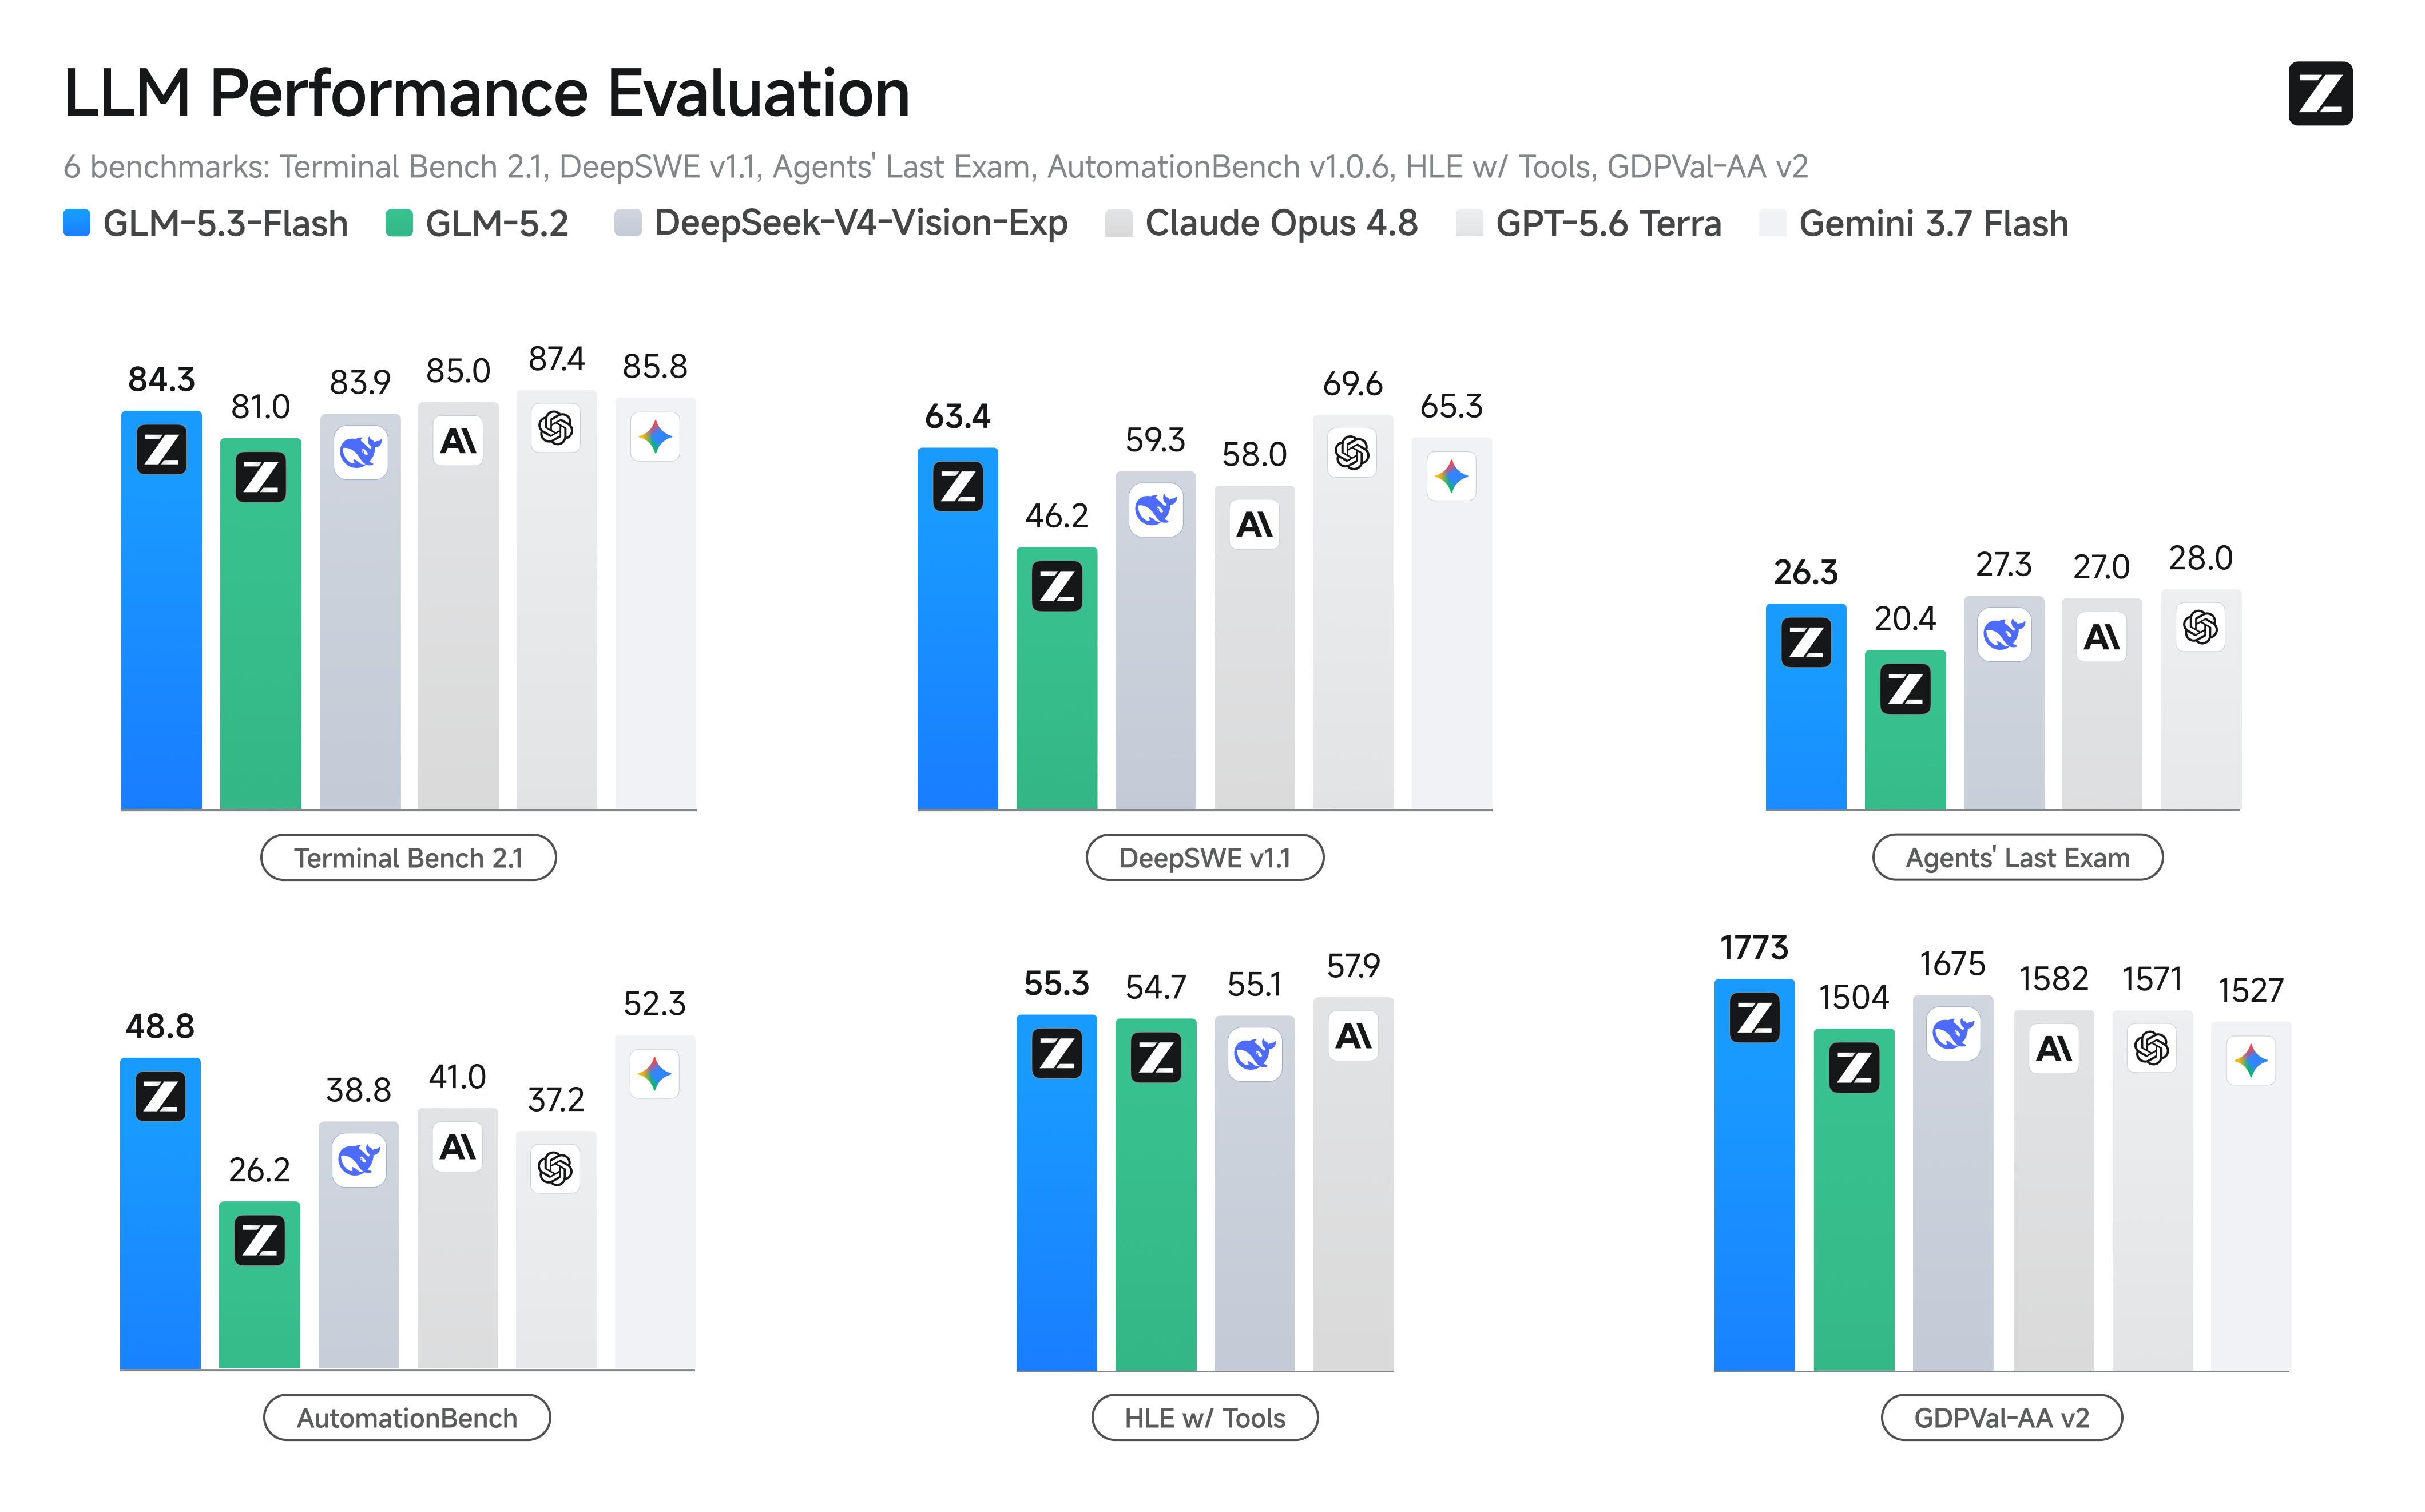
코딩 및 터미널 작업 수행 능력이 두드러진다. Terminal-Bench 2.1 벤치마크에서 84.3점을 기록했으며, DeepSWE에서는 63.4점을 달성했다. 특히 DeepSWE 평가는 400K 컨텍스트 환경에서 mini-swe-agent 하네스를 통해 수행되었다.
복잡한 추론과 도구 사용이 결합된 작업에서도 안정적인 성능을 낸다. HLE(Hard Logic Evaluation) 벤치마크에서 55.3점을 기록했으며, 이 평가는 300K 컨텍스트 관리 전략과 전체 도구 세트를 적용한 상태에서 진행되었다.
Transformer 기반 아키텍처를 사용하며, Jinja 템플릿을 통해 시스템 프롬프트, 도구 정의, 사용자 입력을 구조화하여 처리한다. 도구 호출 시 XML 형식의 태그를 활용해 함수명과 인자를 전달하는 방식을 채택하고 있다.
HuggingFace 모델
zai-org/GLM-5.3-Flash
원문에 등록된 설명이 없습니다.
image-text-to-text
이 한국어 소개글은 AI가 자동으로 만들었습니다. 원문의 주장과 맥락은 원문에서 확인해 주세요. 저작권은 원저작자에게 있습니다.