 AI Briefing
SenseNova-U1.5-8B-MoT: 텍스트와 이미지를 한 모델에서 다루는 8B 통합 멀티모달
sensenova/SenseNova-U1.5-8B-MoT
프로젝트 소개
SenseNova-U1.5-8B-MoT는 텍스트 이해와 이미지 생성, 편집을 하나의 아키텍처에서 처리하는 네이티브 멀티모달 모델이다. NEO-unify 기반의 이 체크포인트는 패치파이 레이어와 데이터 품질, 후학습 파이프라인을 강화해 시각적 일관성과 미적 완성도를 높였다. Apache 2.0 라이선스로 공개되어 있으며 영어와 중국어를 지원한다.
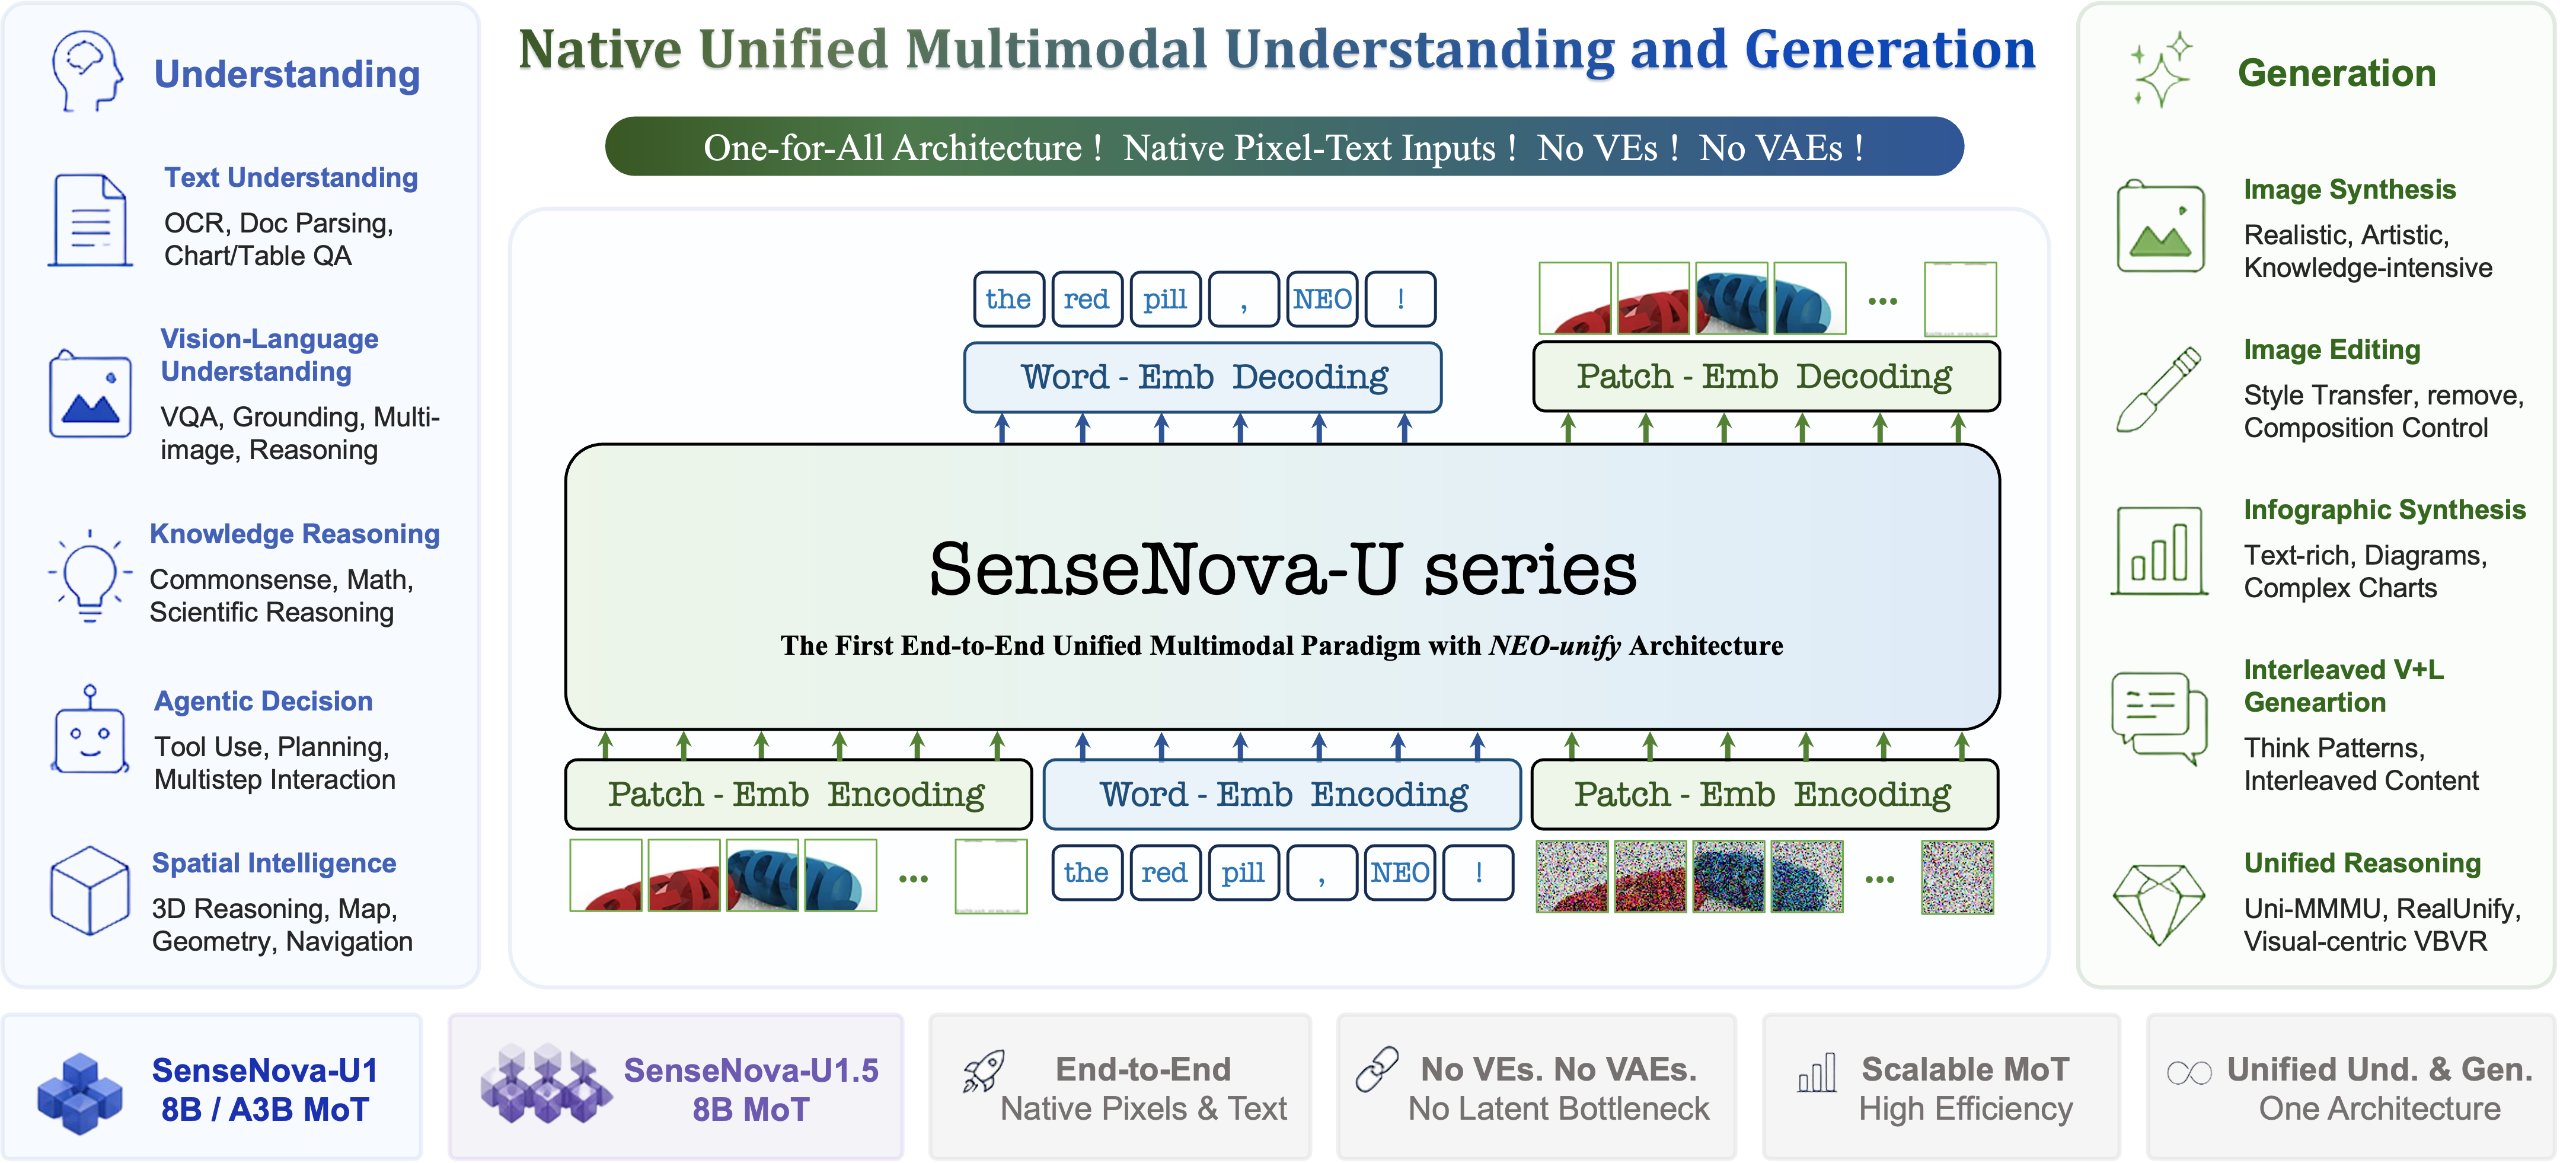
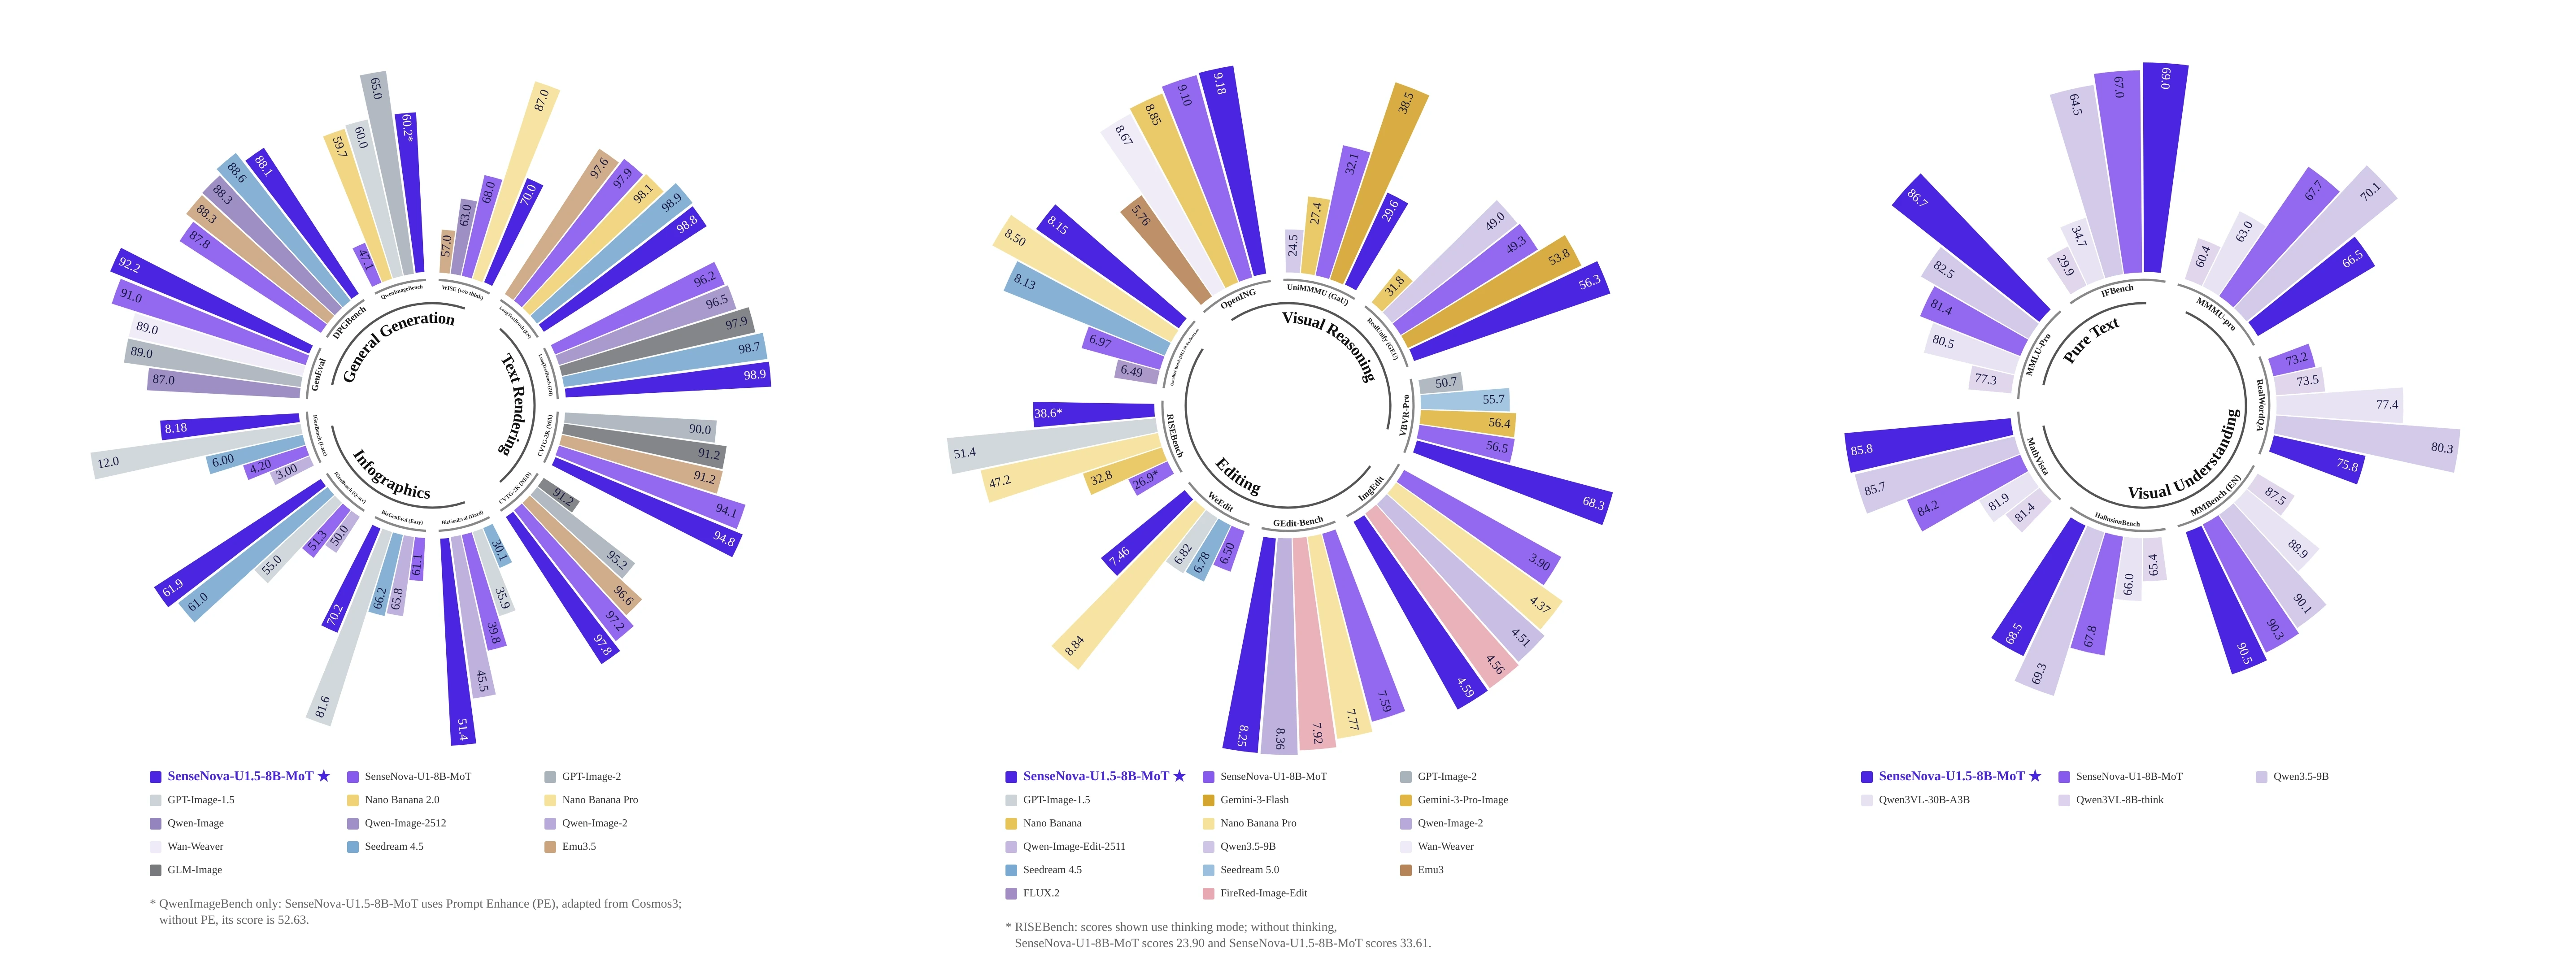
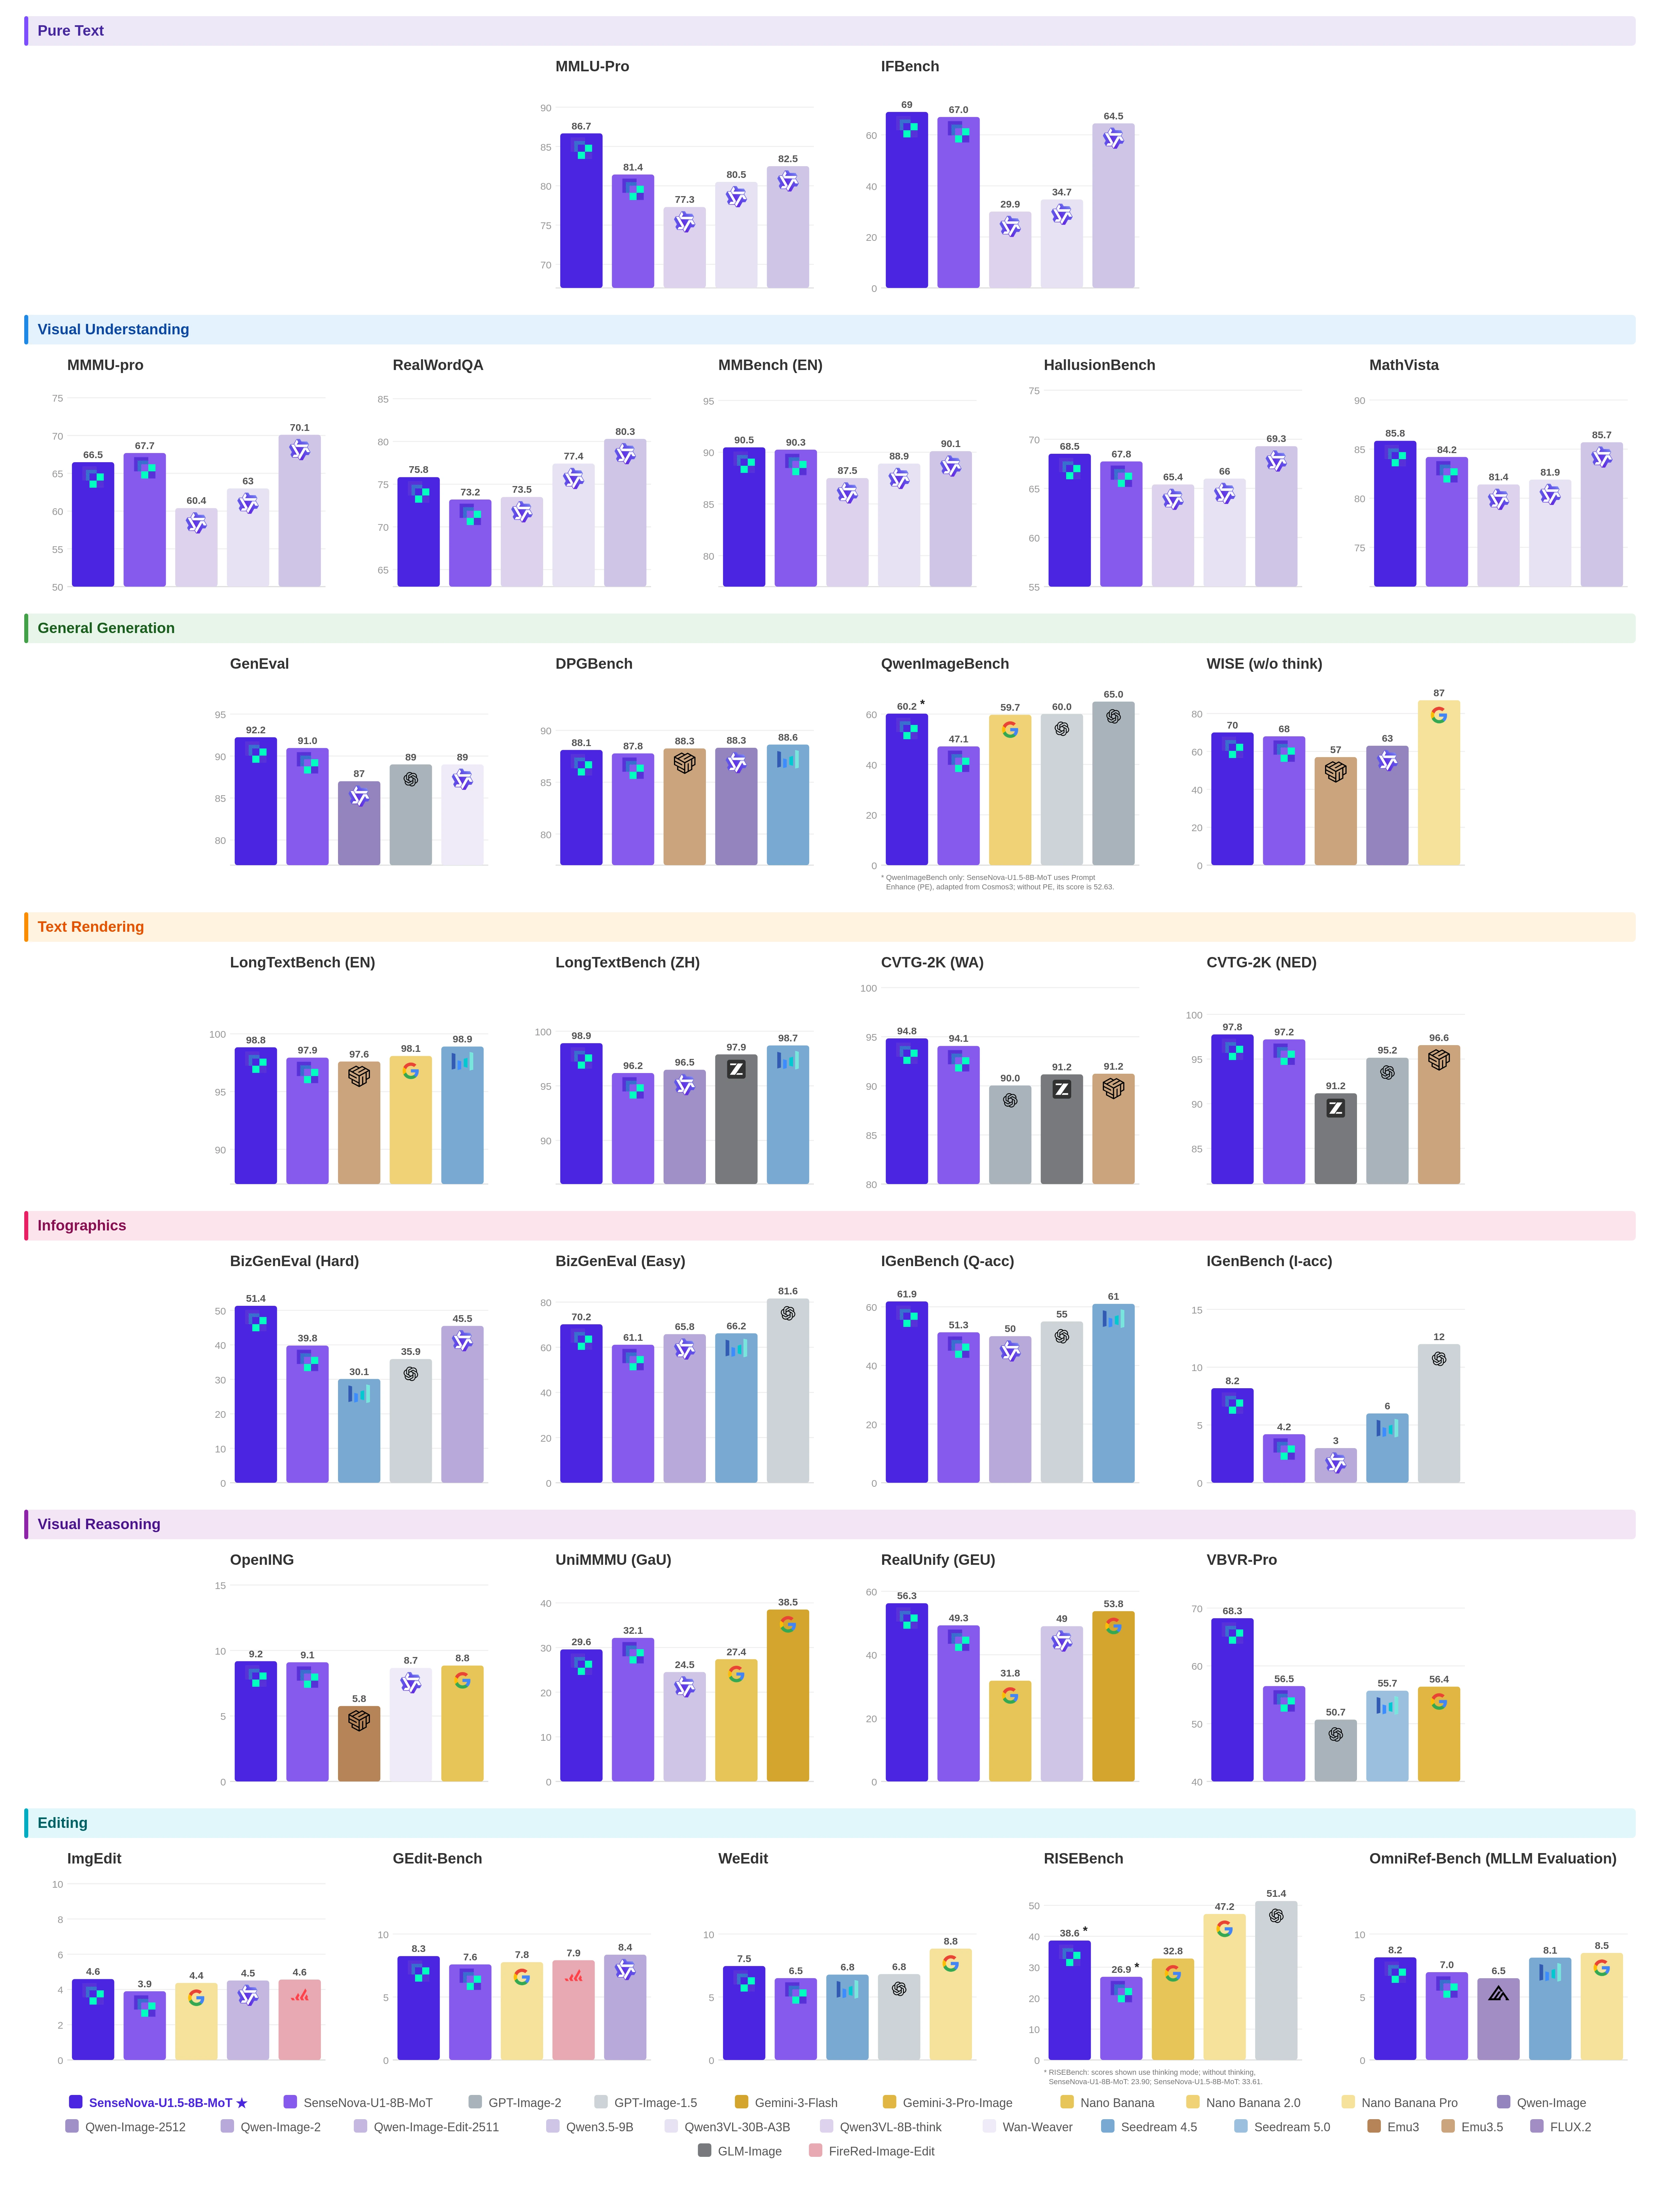
텍스트 프롬프트를 입력하면 4K 해상도의 이미지를 네이티브로 생성하며, 복잡한 지시사항에 따른 객체 배치와 스타일 제어도 준수한다. 이미지가 주어지면 특정 영역만 수정하거나 텍스트를 교체하는 등 정밀한 편집이 가능하다. 바운딩 박스나 시각적 마커를 활용해 대상 수준으로 제어 범위를 지정할 수 있다.
기존 방식과 달리 텍스트 렌더링과 인포그래픽 생성에서 영문과 중문 가독성이 개선되어 포스터나 브랜드 자산 제작에 적합하다. 이미지 편집 시에도 미편집 영역의 주체 동일성과 배경, 조명, 구도를 잘 보존한다. 단일 요청 내에서 객체 수, 공간 관계, 레이아웃 등 여러 제약 조건을 동시에 처리하는 능력이 강화됐다.
GPU 없이 브라우저에서 바로 체험할 수 있는 SenseNova-Studio가 제공되어 초기 테스트에 유리하다. 다만 고밀도 텍스트나 복잡한 레이아웃, 세부적인 인체 구조에서는 여전히 한계가 남아 있어 cfg_scale 조정이나 프롬프트 강화가 필요할 수 있다. 시각적 생성과 편집을 통합적으로 다루는 워크플로우를 구축하려는 개발자에게 적합하다.
sensenova/SenseNova-U1.5-8B-MoT
원문에 등록된 설명이 없습니다.
any-to-any
이 한국어 소개글은 AI가 자동으로 만들었습니다. 원문의 주장과 맥락은 원문에서 확인해 주세요. 저작권은 원저작자에게 있습니다.